사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #2
사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #1최근에 꽤 규모가 있는 프로젝트를 하면서 아키텍처 설계부터 인프라까지 다뤄보며,더 큰 트래픽에 대비하기 위해서는 어떻게 해야
constant1601.tistory.com
이전 글에서는 사용자가 증가함에 따라 하나의 서버에서 시작한 시스템을 어떻게 확장할 수 있는지 알아보았다.
Web Server를 Scale Out하고, Database Replication과 Cache를 적용하고, 이후에는 Auto Scaling, Message Queue, Database Sharding까지 적용하면서 시스템을 확장했다.
그중 Database Sharding에서는 하나의 Database가 모든 데이터를 저장하는 대신 데이터를 여러 개의 Shard에 나누어 저장하는 방법을 공부하면서, 당시에는 이해를 쉽게 하기 위해 다음과 같이 user_id를 이용하여 데이터를 분산했다.
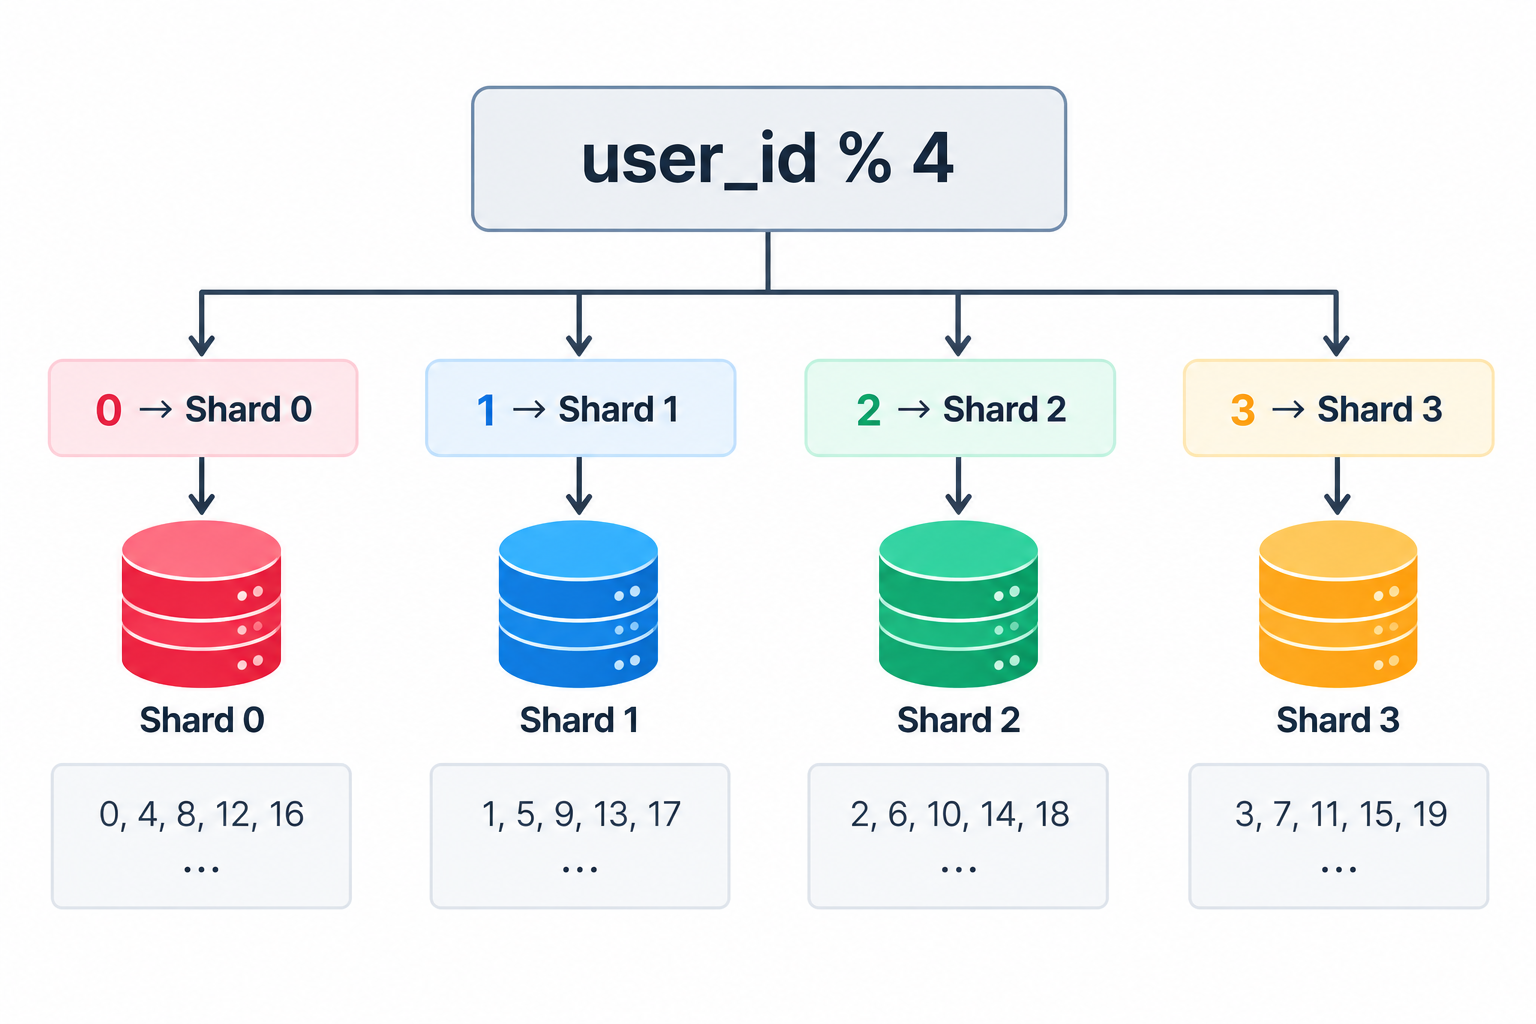
간단하고 데이터도 어느 정도 균등하게 분산할 수 있는 방법처럼 보인다.
그런데 이전 글을 작성하면서 한 가지 의문이 생겼다.
Shard가 추가되거나 제거된다면 기존 데이터는 어떻게 될까?
이를 알아보다가 Consistent Hashing이라는 개념을 접하게 되어 이번 글에서는 이에 대해 알아보려고 한다.
Modulo Hashing
먼저 일반적인 Hash 기반의 데이터 분산 방법부터 살펴보자.
4개의 서버가 있다고 가정해보자.
어떤 Key를 저장할 서버를 결정하기 위해 Key의 Hash 값을 구하고 서버의 개수로 나눈 나머지를 사용할 수 있다.
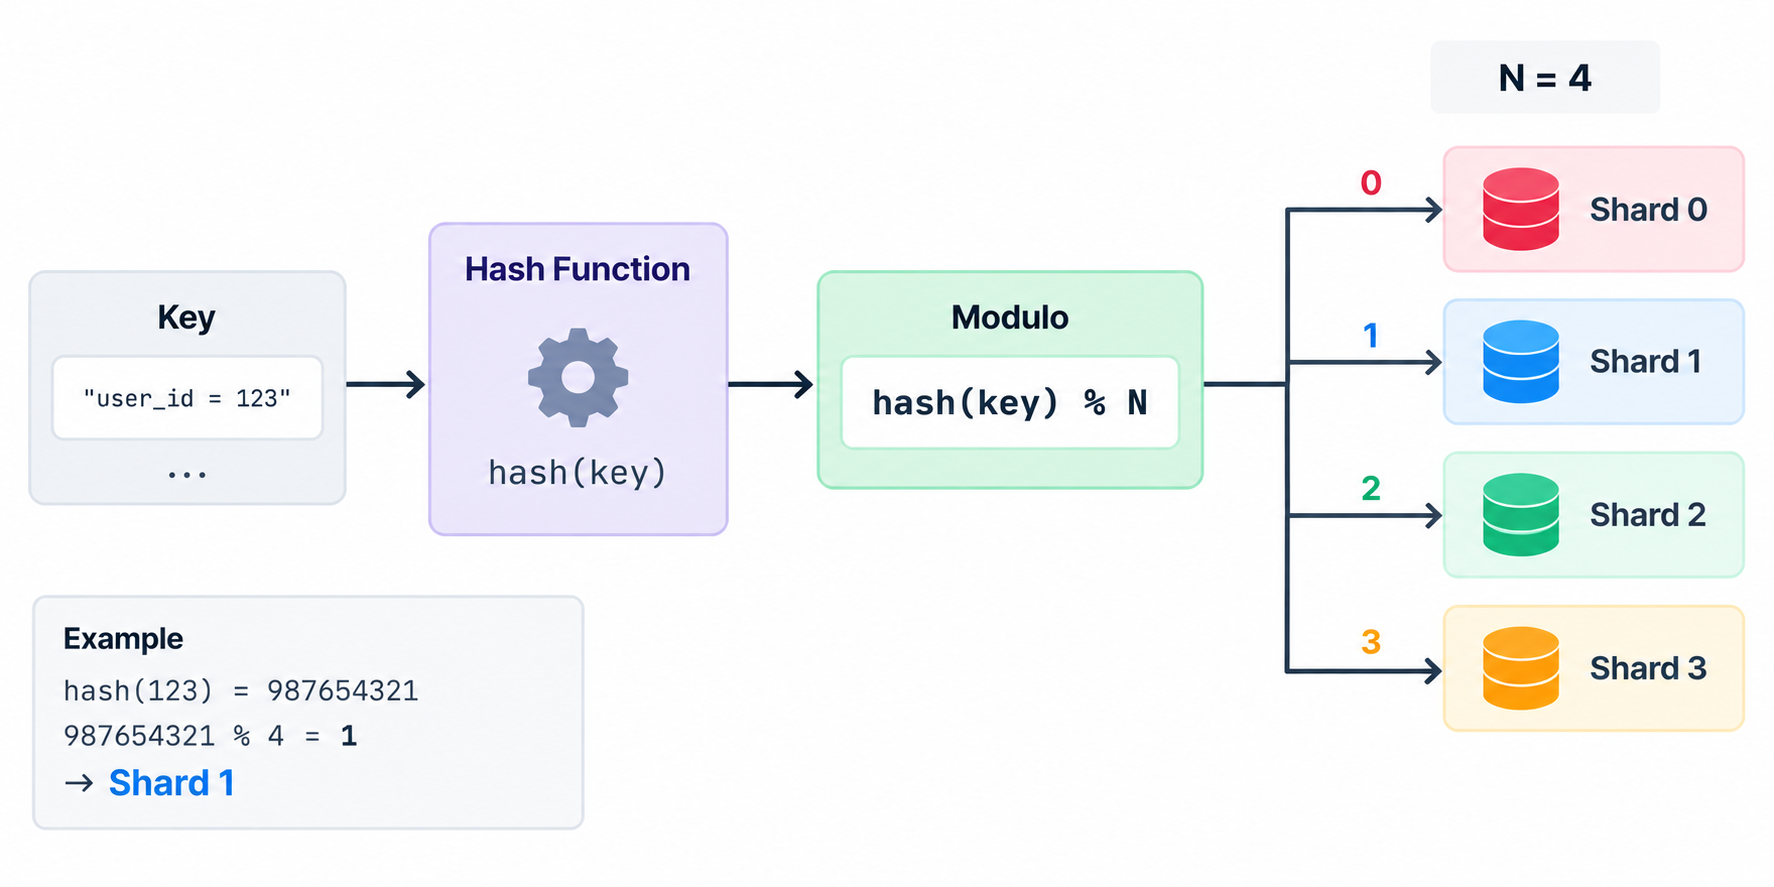
N은 현재 존재하는 서버의 개수이다.
예를 들어 Hash 값이 다음과 같다고 가정해보자.
A → 7 % 4 = 3 → Server 3
B → 10 % 4 = 2 → Server 2
C → 12 % 4 = 0 → Server 0
와 같이 데이터를 분산할 수 있다.
구현도 단순하고 Hash 값이 적절하게 분산된다면 각각의 서버에 데이터를 비교적 고르게 저장할 수도 있다.
서버가 하나 추가된다면?
하지만 서비스가 성장하여 서버 한 대를 추가해야 한다고 가정해보자.
서버가 4대에서 5대가 되었기 때문에 기존의
hash(key) % 4 가 hash(key) % 5 로 변경된다.
아까 사용했던 값을 다시 계산해보면 결과가 달라진다.
| Key | Hash | % 4 | % 5 |
| A | 7 | Server 3 | Server 2 |
| B | 10 | Server 2 | Server 0 |
| C | 12 | Server 0 | Server 2 |
서버 한 대를 추가했을 뿐인데 A, B, C 모두 저장되어야 하는 서버가 변경되었다.
데이터가 세 개뿐이라면 별 문제가 없어 보일 수 있지만, 수백만 개의 데이터가 저장되어 있다면 이야기가 달라진다.
서버 하나를 추가하거나 제거할 때마다 수많은 데이터의 위치가 변경되고, 이를 새로운 서버로 다시 이동시켜야 할 수 있다.
결국 단순한 Modulo 방식에서는 서버의 개수 N이 변경되는 것이 Hash 결과 전체에 영향을 준다.
그렇다면 서버가 추가되거나 제거되더라도 기존 데이터의 위치를 최대한 유지할 수는 없을까?
이를 해결하기 위해 사용할 수 있는 방법 중 하나가 Consistent Hashing이다.
Consistent Hashing
Consistent Hashing은 1997년 David Karger 등이 발표한 논문 Consistent Hashing and Random Trees에서 제안된 방법이다.
일반적인 Modulo Hashing에서는 서버의 개수가 Hash 계산에 직접 사용되었다.
따라서 N이 변경되면 많은 Key의 결과 역시 함께 변경되었다.
Consistent Hashing에서는 이와 다르게 고정된 Hash 공간 위에 서버와 Key를 함께 배치한다.
예를 들어 Hash 값의 범위가 다음과 같다고 가정해보자.
0 ~ 2^32 - 1
이를 원형으로 연결하면 하나의 Ring처럼 표현할 수 있다.
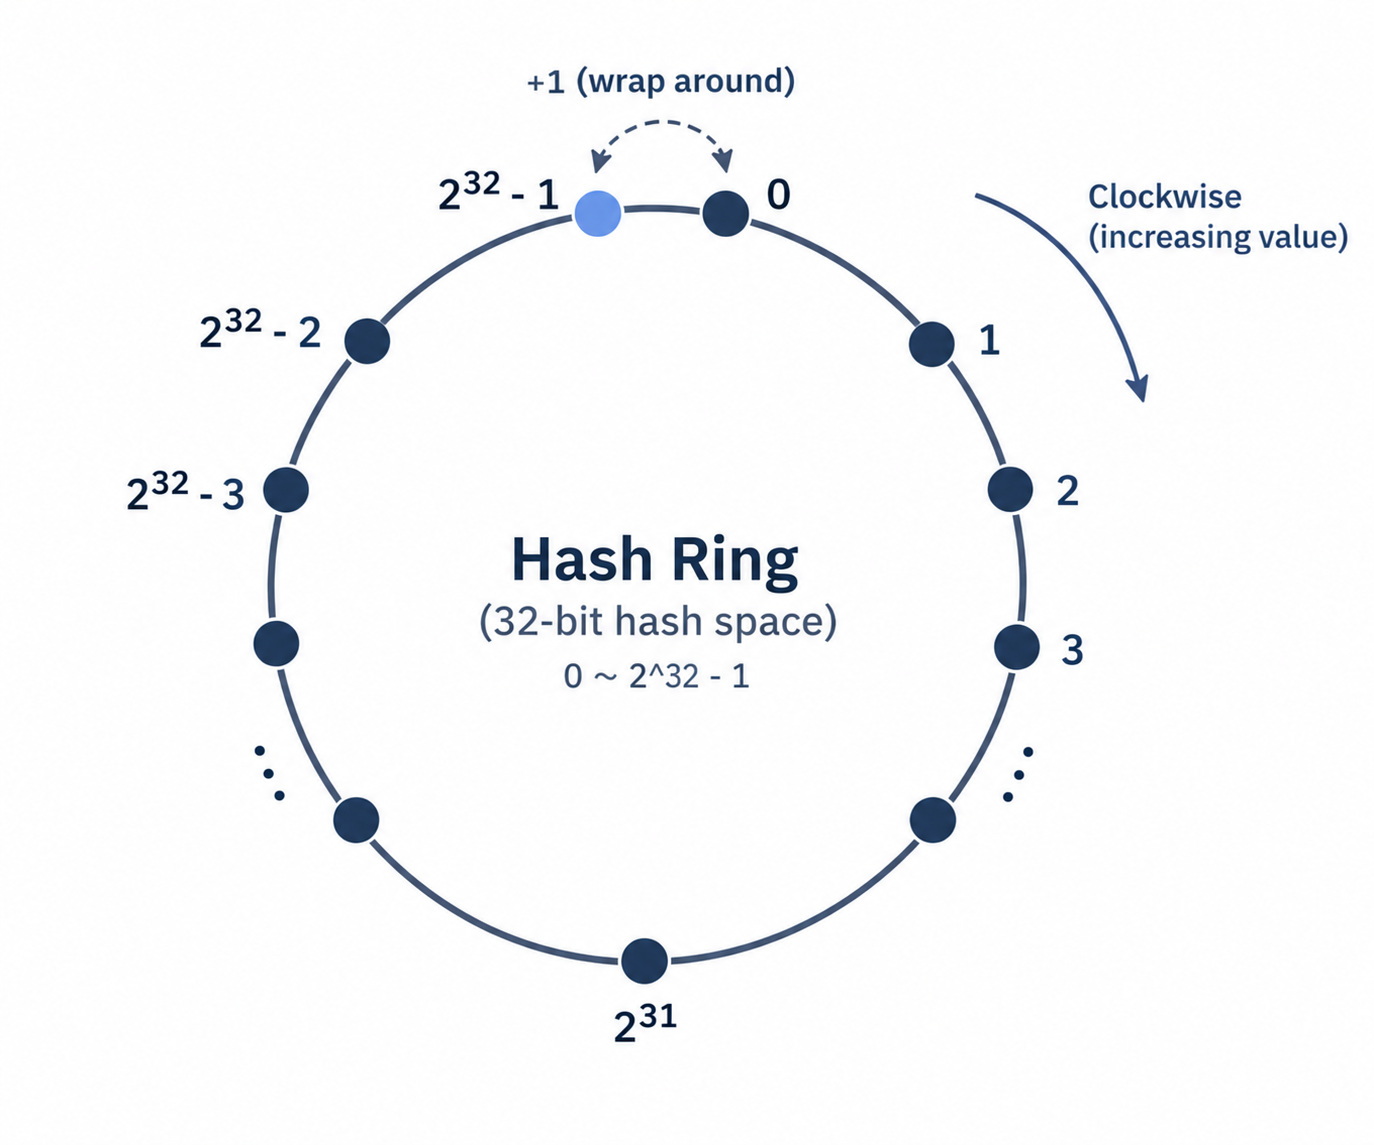
이를 Hash Ring이라고 한다.
Server를 Hash Ring에 배치한다
먼저 각각의 Server를 Hash Function에 넣어 Hash 값을 계산한다.
hash(Server A)
hash(Server B)
hash(Server C)
그리고 그 결과에 따라 Hash Ring 위에 Server를 배치한다.
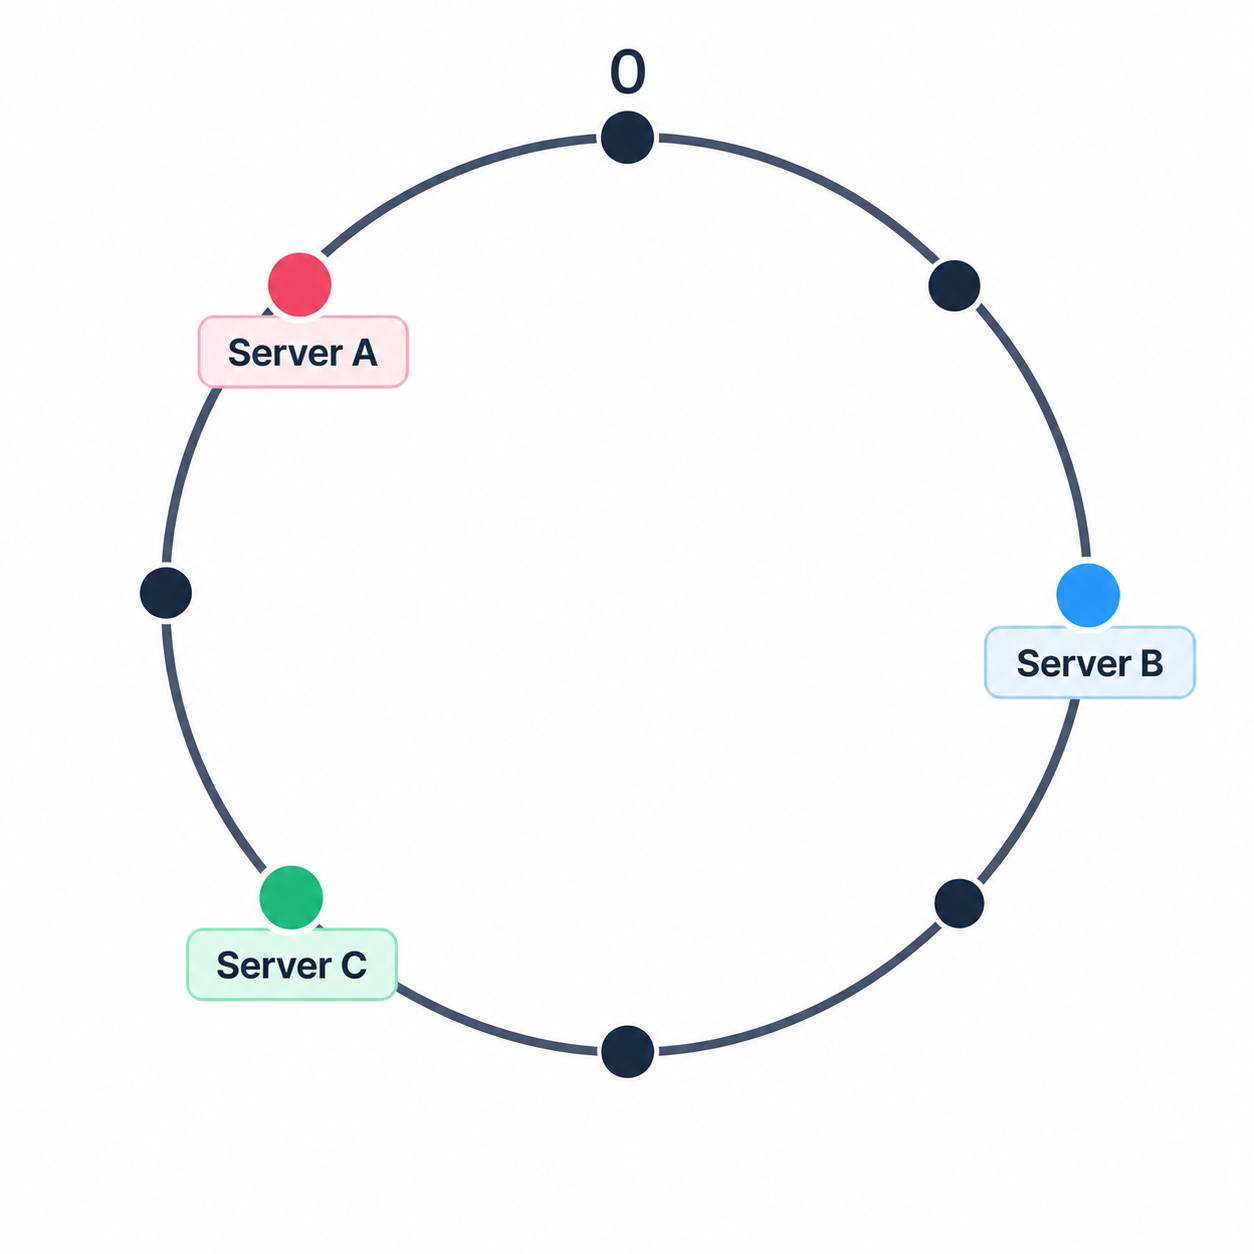
실제로 서버가 물리적으로 원형으로 연결되어 있다는 뜻은 아니다.
Hash 값을 이해하기 쉽게 논리적인 Ring 형태로 표현한 것이다.
Key도 같은 Ring에 배치한다.
데이터의 Key 역시 동일한 Hash Function을 사용한다.
hash(Key A)
hash(Key B)
hash(Key C)
그러면 Server와 마찬가지로 Key도 Hash Ring 위의 특정 위치를 가지게 된다.
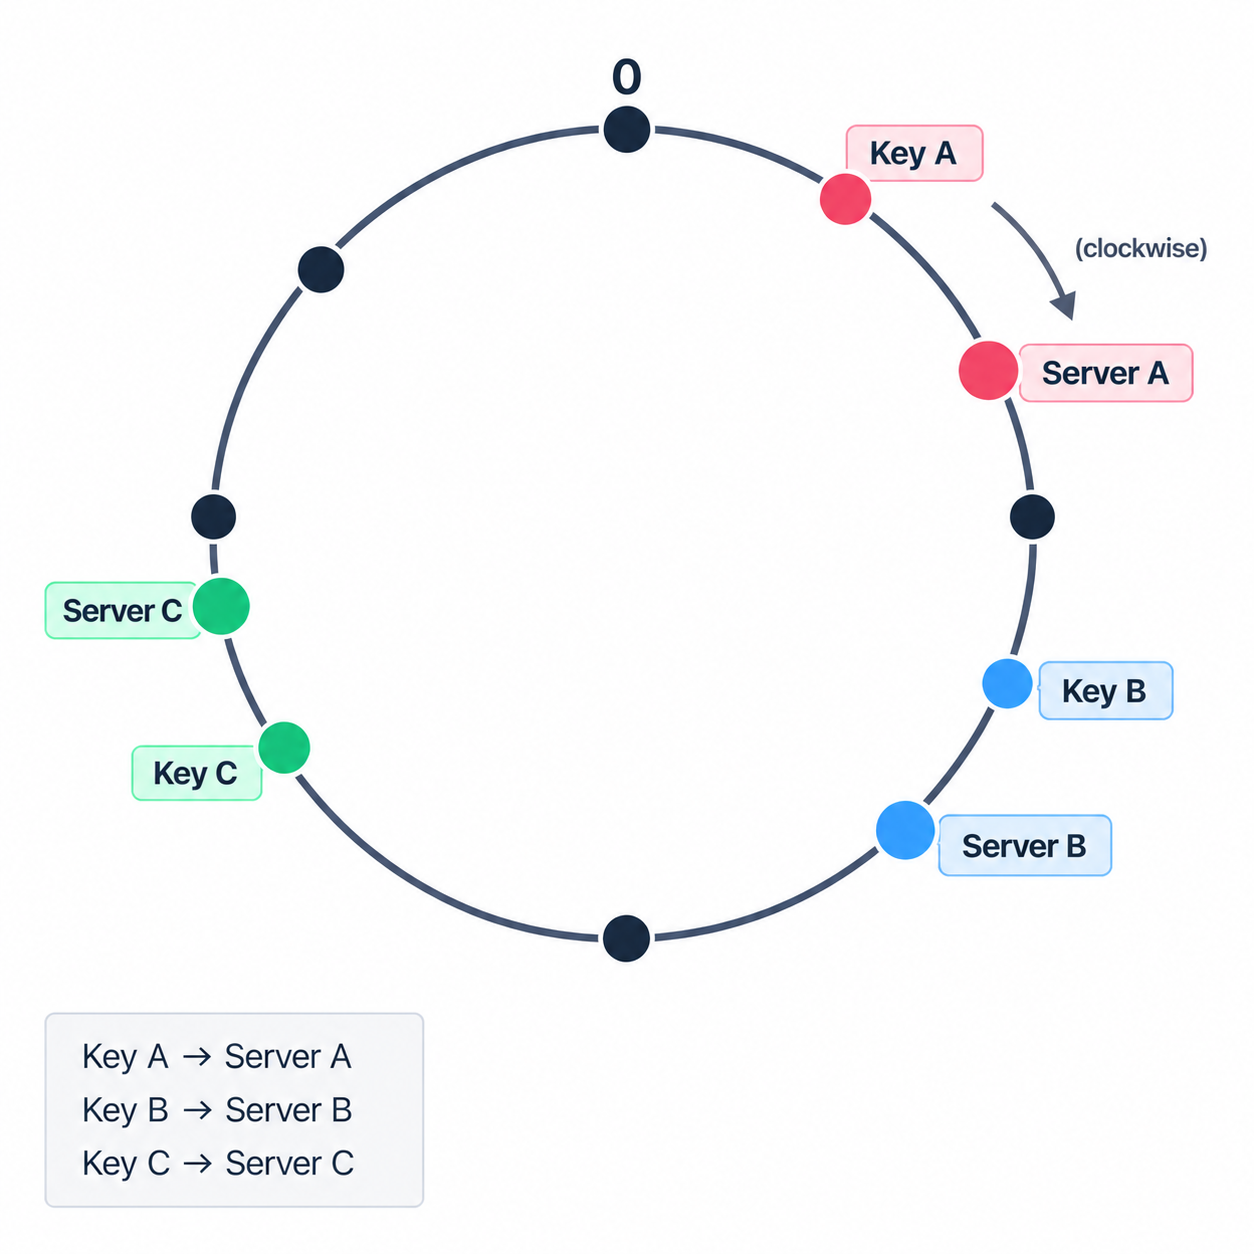
이제 각 Key를 어떤 Server에 저장할지 결정해야 한다.
일반적인 Consistent Hashing에서는 Key의 위치에서 시계 방향으로 이동했을 때 처음 만나는 Server가 해당 Key를 담당하도록 한다.
예를 들어
Key A → Server A
Key B → Server B
Key C → Server C
와 같은 식이다.
Server가 추가된다면?
이제 Consistent Hashing을 사용하는 상태에서 새로운 Server D를 추가한다고 가정해보자.
Server D 역시 Hash Function을 통해 Ring의 특정 위치에 배치된다.
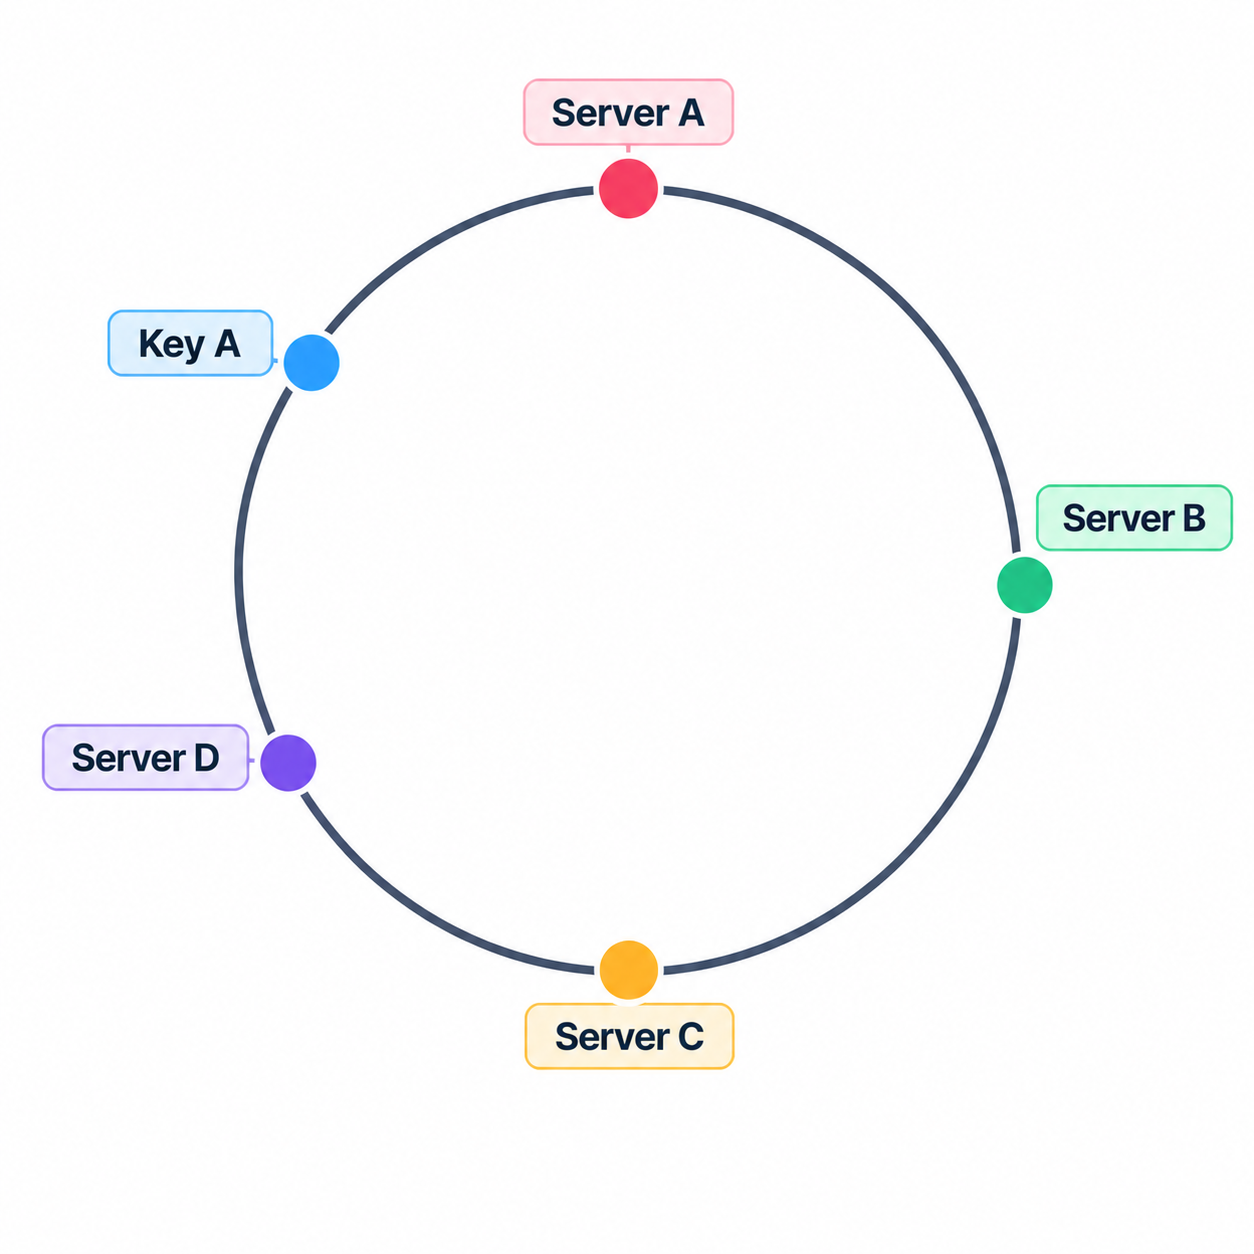
여기서 중요한 점은 모든 Key의 위치를 다시 계산할 필요가 없다는 것이다.
Server D가 새롭게 담당하게 된 범위에 존재하는 Key들만 Server D로 이동하면 된다.
예를 들어 기존에 Server B가 담당하던 일부 Key가 Server D의 범위에 포함되었다면
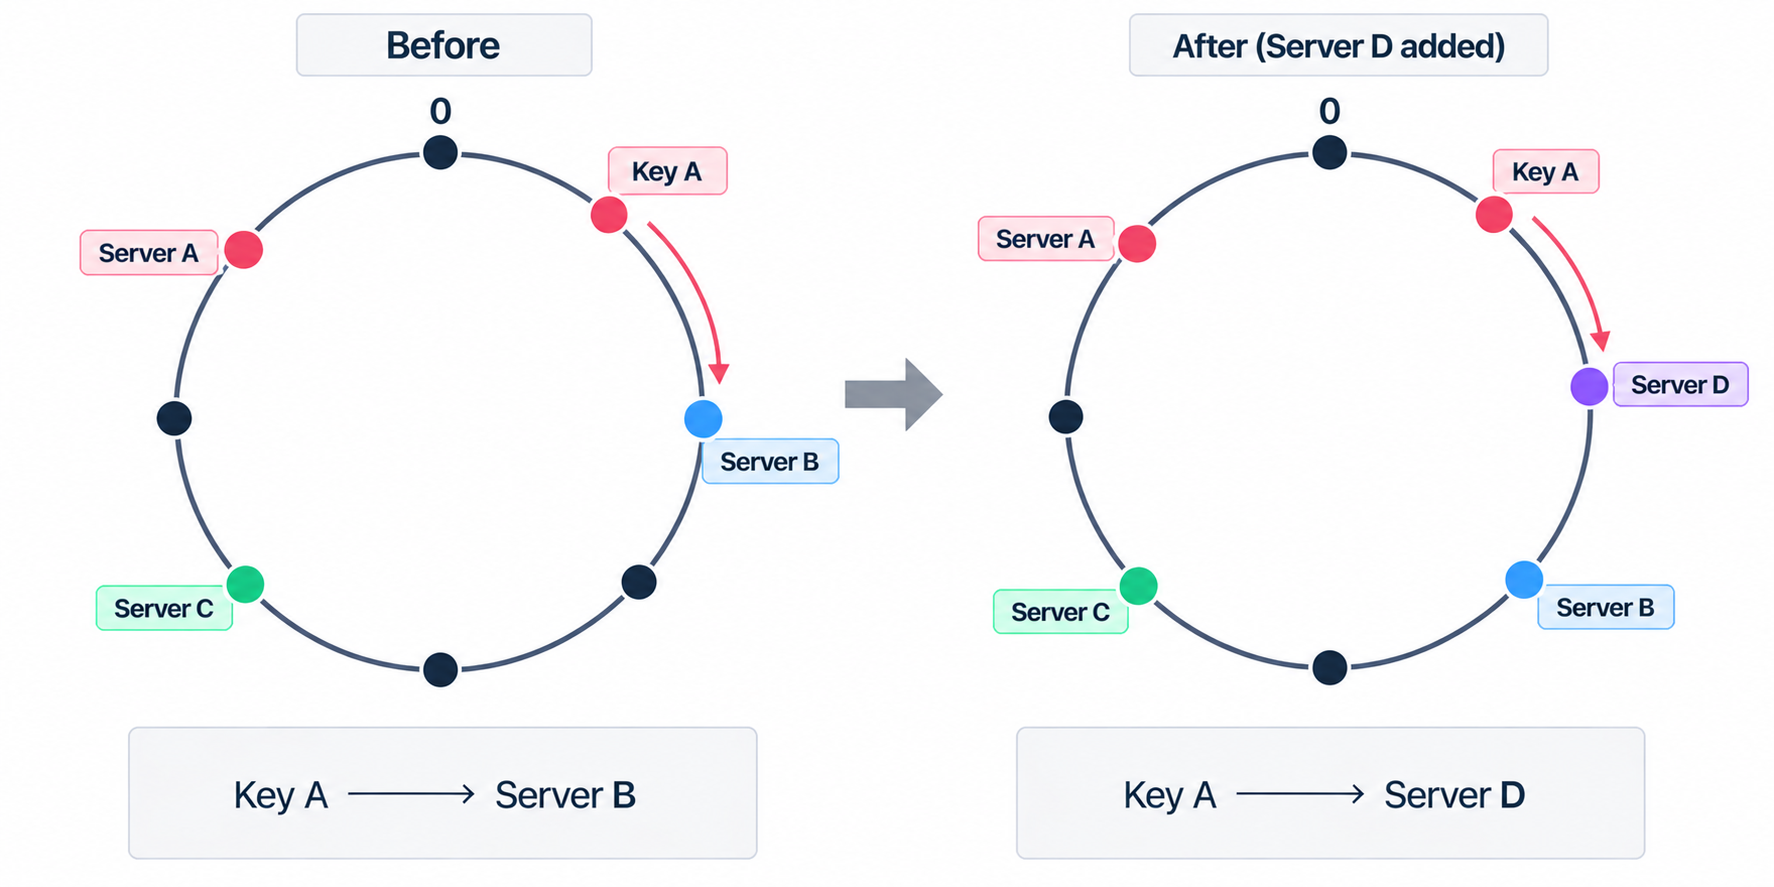
처럼 해당 범위의 데이터만 이동한다.
나머지 Server A, C 등이 담당하던 Key는 그대로 유지할 수 있다.
즉 Modulo Hashing에서는 서버의 개수가 변경되면서 많은 Key의 매핑 결과가 변경되었지만,
Consistent Hashing에서는 새로운 Server와 인접한 일부 Key만 이동하게 만들 수 있다.
Server가 제거된다면?
반대로 Server 하나에 장애가 발생하거나 서버를 제거해야 하는 경우도 생각해볼 수 있다.
예를 들어 Server B가 사라졌다고 가정해보자.
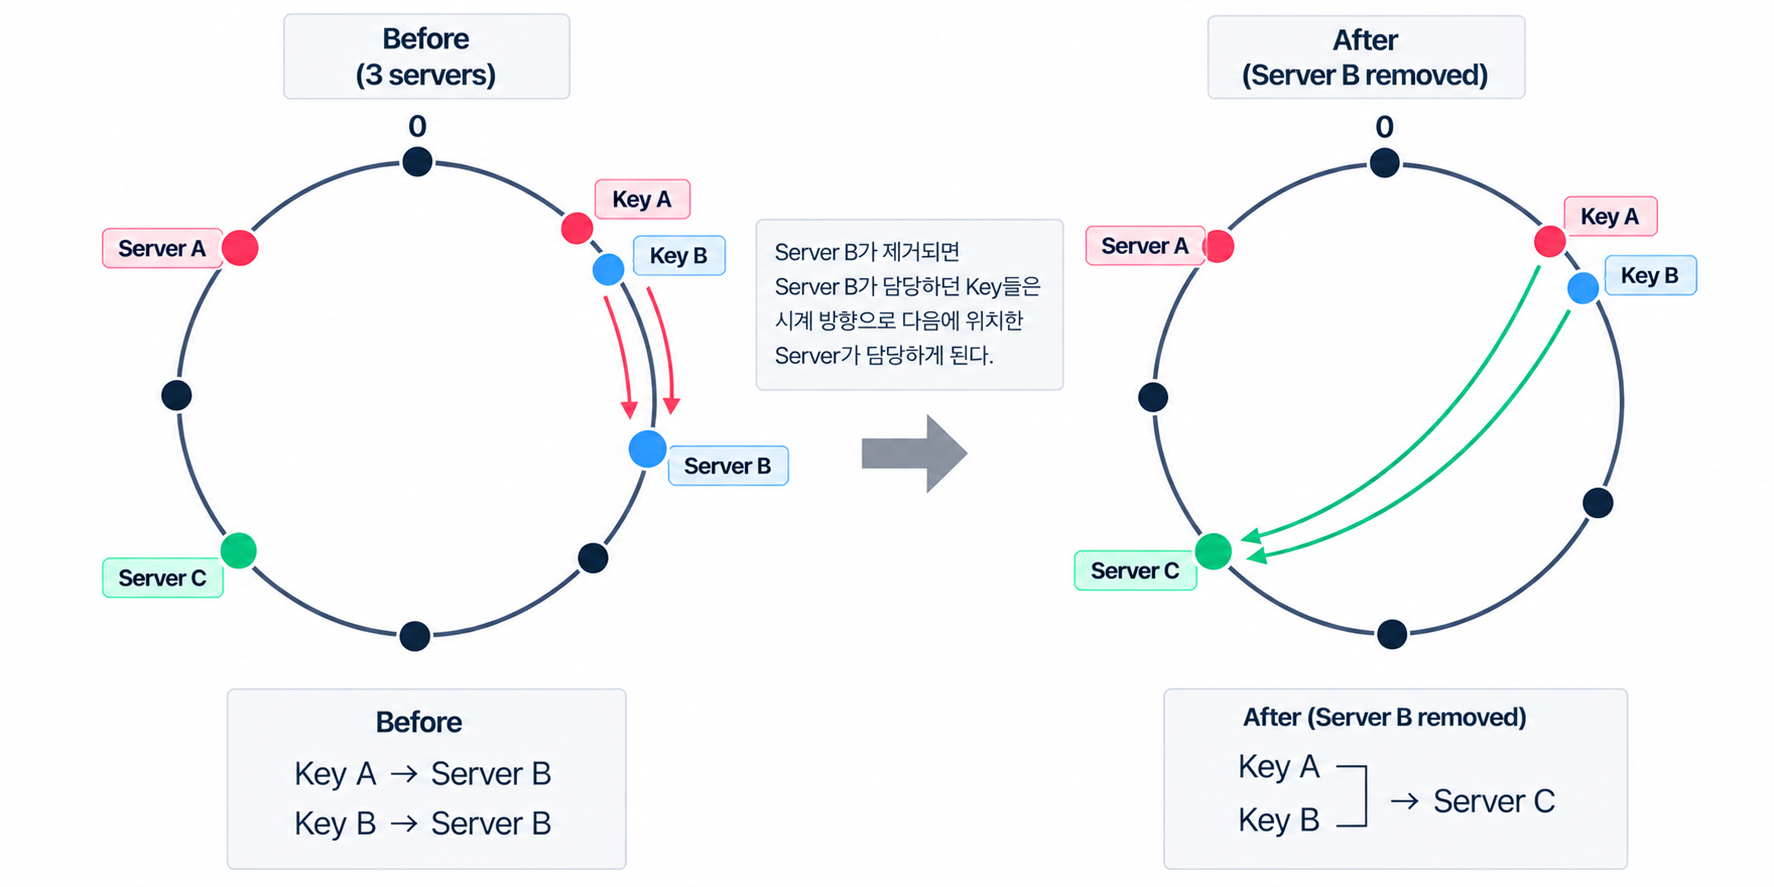
이 경우에도 다른 Server들이 담당하고 있던 모든 데이터를 다시 배치할 필요는 없다.
Server B가 담당하던 범위의 데이터만 이동하면 된다.
이것이 Consistent Hashing의 가장 큰 특징 중 하나이다.
그런데 정말 균등하게 분산될까?
여기까지 보면 Consistent Hashing이 상당히 이상적인 방법처럼 보인다.
하지만 또 다른 문제가 있다.
Hash Function을 통해 Server의 위치를 결정하기 때문에 Server들이 Ring 위에 항상 균등하게 배치된다고 보장할 수 없다.
예를 들어 다음과 같이 Server가 배치될 수도 있다.
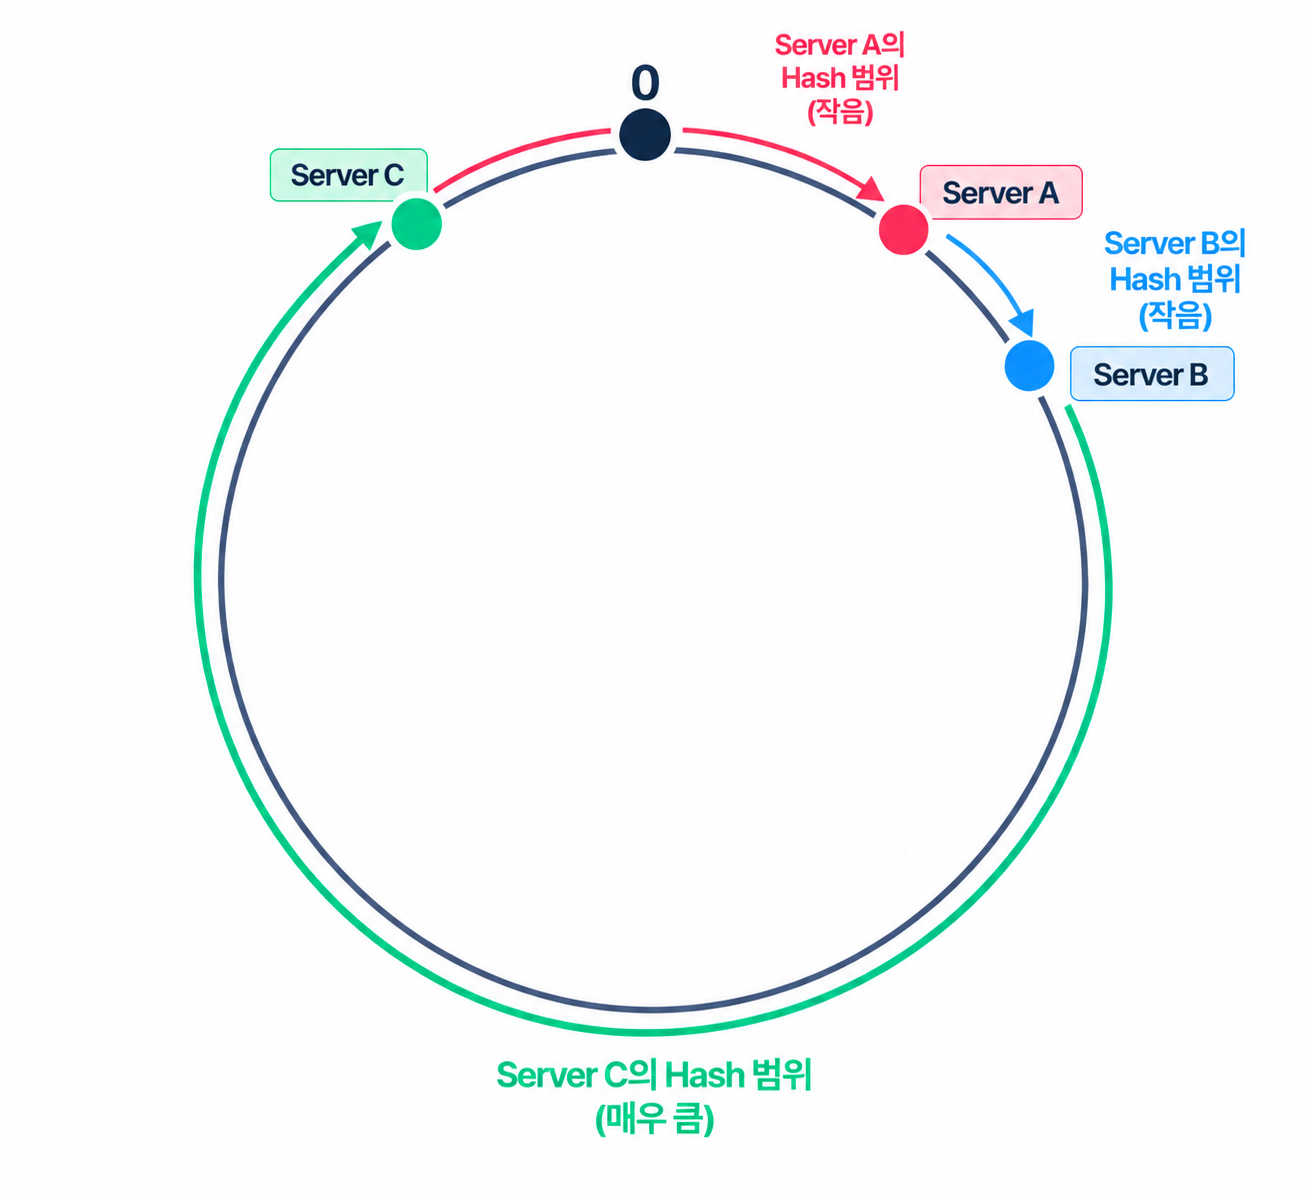
Server A와 Server B는 서로 가까이 있는데 Server B와 Server C 사이의 공간은 매우 크다.
이 경우 각 Server가 담당하는 Hash 범위 역시 달라진다.
Server A → 20%
Server B → 10%
Server C → 70%
결국 Server C에 훨씬 많은 데이터와 요청이 몰릴 수도 있다.
Server의 수가 많아질수록 어느 정도 완화될 수 있지만, 단순히 물리적인 Server 하나를 Hash Ring의 한 지점에만 배치하는 것으로는 균등한 분산을 보장하기 어렵다.
이를 해결하기 위해 사용할 수 있는 방법 중 하나가 Virtual Node이다.
Virtual Node
Virtual Node는 하나의 실제 Server를 Hash Ring 위의 여러 위치에 배치하는 방식이다.
예를 들어 Server A 하나를
Server A-1
Server A-2
Server A-3
과 같이 여러 개의 Virtual Node로 표현할 수 있다.
Server B, C도 마찬가지이다.
Server B-1
Server B-2
Server B-3
Server C-1
Server C-2
Server C-3
그러면 Hash Ring에는 실제 Server 3개가 아니라 여러 개의 Virtual Node가 분산되어 배치된다.
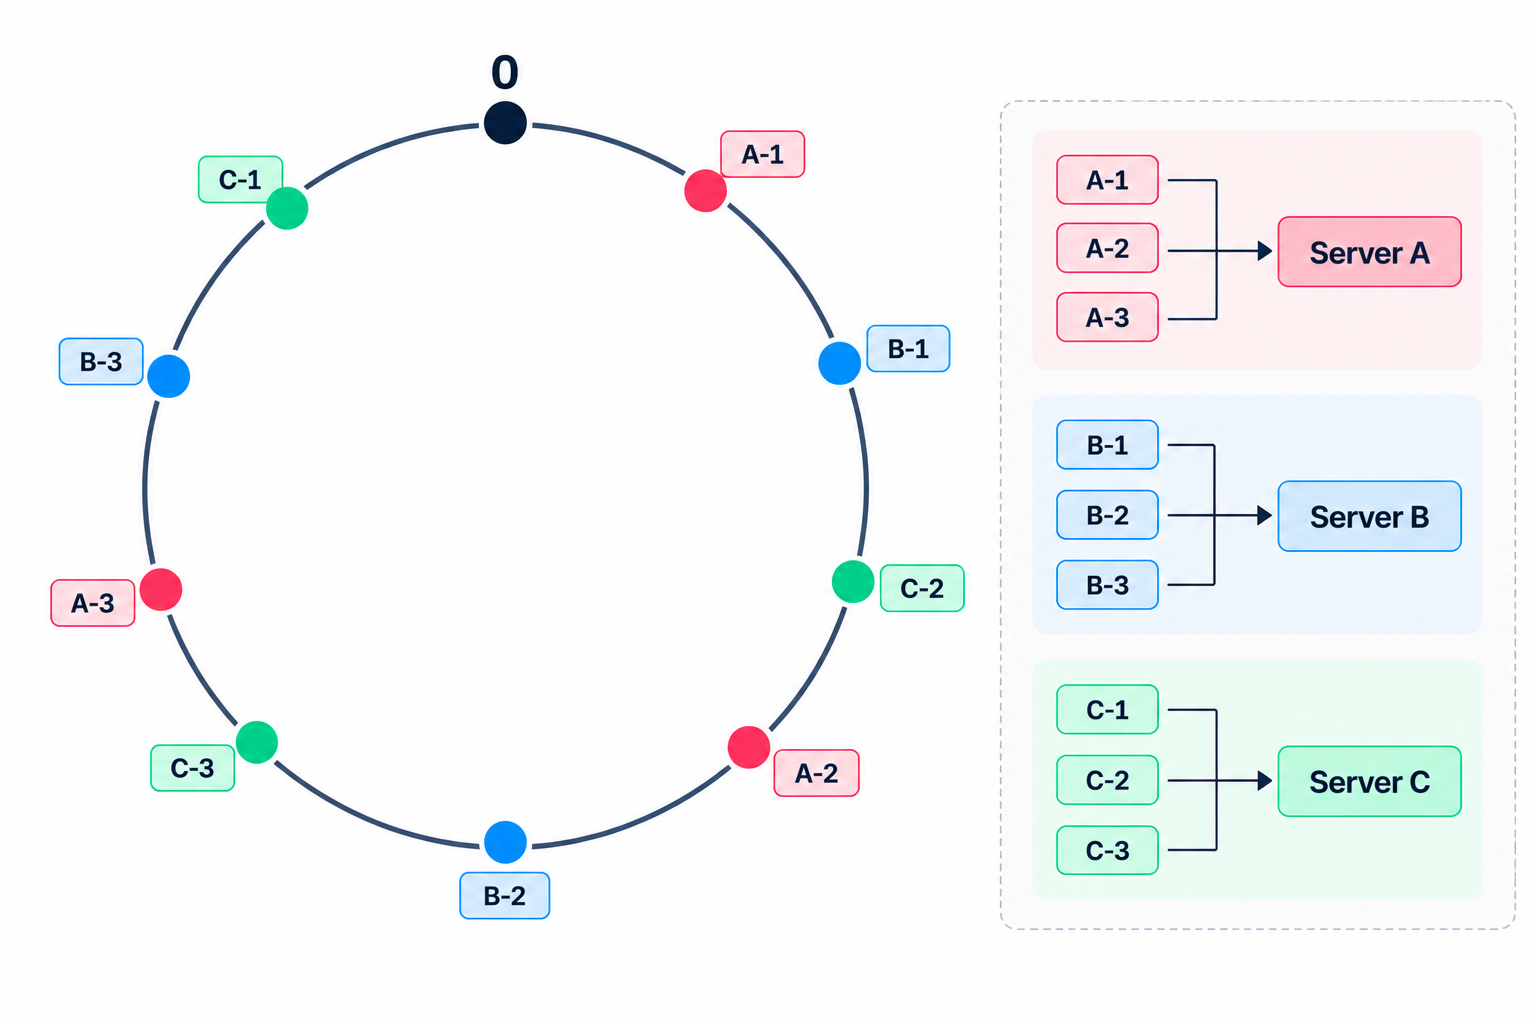
하지만 실제로 데이터를 저장하는 물리적인 Server는 여전히 A, B, C 3대이다.
하나의 Server가 Ring의 여러 영역을 나누어 담당하게 되면서 특정 Server 하나가 지나치게 큰 범위를 담당하는 문제를 줄일 수 있다.
Virtual Node의 수를 늘릴수록 일반적으로 데이터 분포를 보다 균등하게 만들 수 있다.
Consistent Hashing은 어디에 사용될까?
Consistent Hashing은 단순히 Database Sharding에서만 사용되는 개념은 아니다.
분산 Cache, 분산 Database, Storage System 등 여러 노드에 데이터를 분산해야 하는 시스템에서 활용할 수 있다.
대표적인 사례 중 하나가 Amazon의 Dynamo이다.
Amazon이 발표한 Dynamo 논문에서도 Consistent Hashing을 이용해 데이터를 여러 Node에 Partition하는 구조를 설명하고 있다.
다만 실제 대규모 시스템에서는 지금까지 설명한 단순한 Hash Ring만 사용하는 것이 아니라 Replication, Failure Detection, 데이터 일관성, Node의 용량 차이 등 훨씬 많은 요소를 함께 고려하게 된다.
정리
처음에는 데이터를 여러 Shard에 나누기 위해 단순한 Modulo Hashing을 사용했다.
hash(key) % N
구현이 간단하다는 장점이 있지만 Server의 개수 N이 변경되면 많은 Key의 매핑 결과 역시 함께 변경된다는 문제가 있었다.
Consistent Hashing은 Server와 Key를 고정된 Hash 공간에 배치하여 이러한 문제를 줄인다.
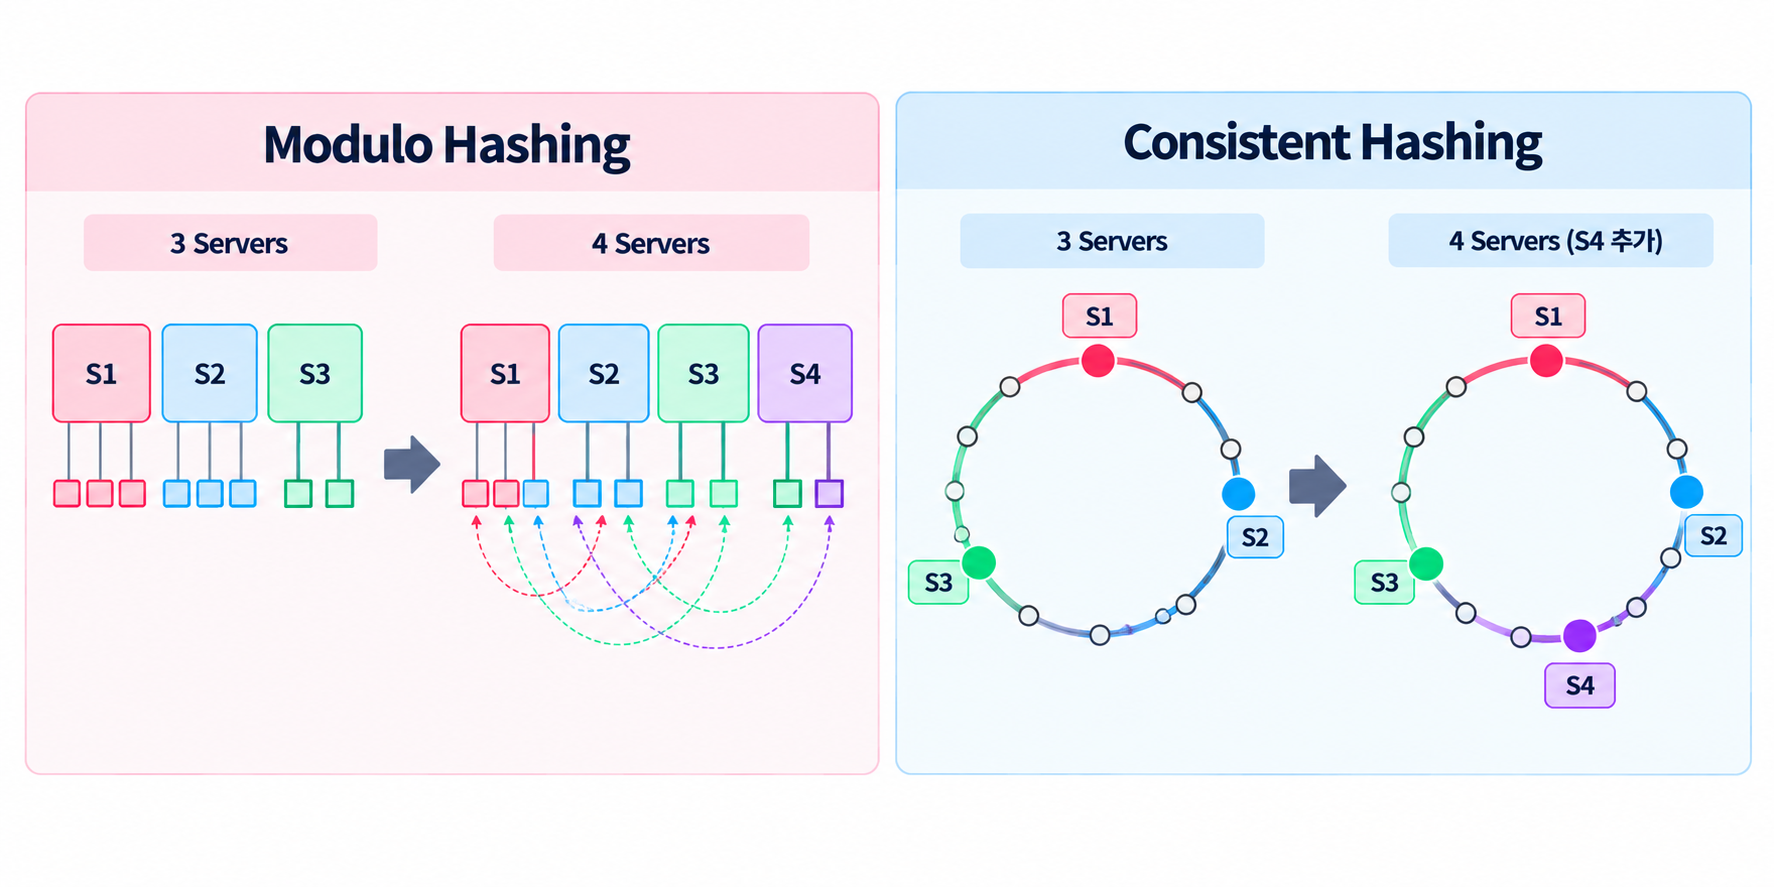
여기에 Virtual Node를 사용하면 하나의 물리적인 Server를 Hash Ring의 여러 위치에 배치하여 데이터가 특정 Server에 몰리는 문제도 줄일 수 있다.
결국 Consistent Hashing의 핵심은 단순히 데이터를 Hash로 나누는 것보다는,
시스템을 Scale Out하거나 장애로 Node가 사라지는 상황에서도 데이터의 재배치를 최소화하면서 시스템을 확장할 수 있도록 만드는 것에 있다고 볼 수 있다.
이전 글에서 user_id % 4라는 단순한 예제로 Sharding을 알아봤을 때는 크게 생각하지 않았던 부분인데, 실제로 서버가 계속 추가되고 제거되는 분산 환경까지 생각해보니 단순한 Hash 방식에도 고려해야 할 부분이 꽤 많다는 것을 알 수 있었다.
참고
Dynamo: Amazon’s highly available key-value store
Reliability at massive scale is one of the biggest challenges we face at Amazon.com, one of the largest e-commerce operations in the world; even the slightest outage has significant financial consequences and impacts customer trust. The Amazon.com platform
www.amazon.science
'CS' 카테고리의 다른 글
| Retry, Backoff, Jitter (0) | 2026.10.04 |
|---|---|
| Rate Limiter (0) | 2026.10.03 |
| [네트워크] ICMP 프로토콜 (1) | 2026.01.10 |
| [네트워크] ARP 프로토콜 (0) | 2026.01.08 |
| [네트워크] 라우팅, 클래스풀 IP, 클래스리스 IP (0) | 2025.12.20 |