사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #1
최근에 꽤 규모가 있는 프로젝트를 하면서 아키텍처 설계부터 인프라까지 다뤄보며,더 큰 트래픽에 대비하기 위해서는 어떻게 해야할지 궁금증이 생겼다. 요즘은 흔히들 AI-Native라고 하여 대부
constant1601.tistory.com
이전 글에 이어서 그 다음 내용을 다뤄볼까 한다.
System Design · Coding · Behavioral · Machine Learning Interviews
Ace Every Stage of Your Next Technical Interview
bytebytego.com
이전 글에서는 위의 포스트를 기반으로 하나의 서버에서 시작하여 사용자가 증가함에 따라 발생하는 문제들을 하나씩 해결해보았다.
처음에는 Web Server와 Database를 분리했고, 하나의 서버로 트래픽을 감당하기 어려워지면서 Scale Out과 Load Balancer를 적용했다.
이후 Database Replication을 통해 Database의 부하를 분산하고, Cache와 CDN을 추가하여 반복적인 요청으로 인해 발생하는 부하를 줄이는 과정까지 알아보았다.
여기까지 구성하면 꽤 많은 트래픽을 처리할 수 있는 구조가 만들어진 것처럼 보인다.
하지만 사용자가 계속해서 늘어난다면 아직 해결해야 할 문제들이 남아있다.
이번 글에서는 이전 글에서 구성한 시스템을 기반으로 Stateless Web Tier, Auto Scaling, Multi Data Center, Message Queue, Database Sharding 등을 추가하며 시스템을 한 단계 더 확장해보려고 한다.
Stateless Web Tier
이전 글에서는 트래픽이 증가했을 때 Web Server를 Scale Out하여 여러 대의 서버로 요청을 분산하는 방법을 알아보았다.
단순하게 생각하면 트래픽이 증가할 때마다 Web Server를 추가하면 계속해서 시스템을 확장할 수 있을 것처럼 보인다.
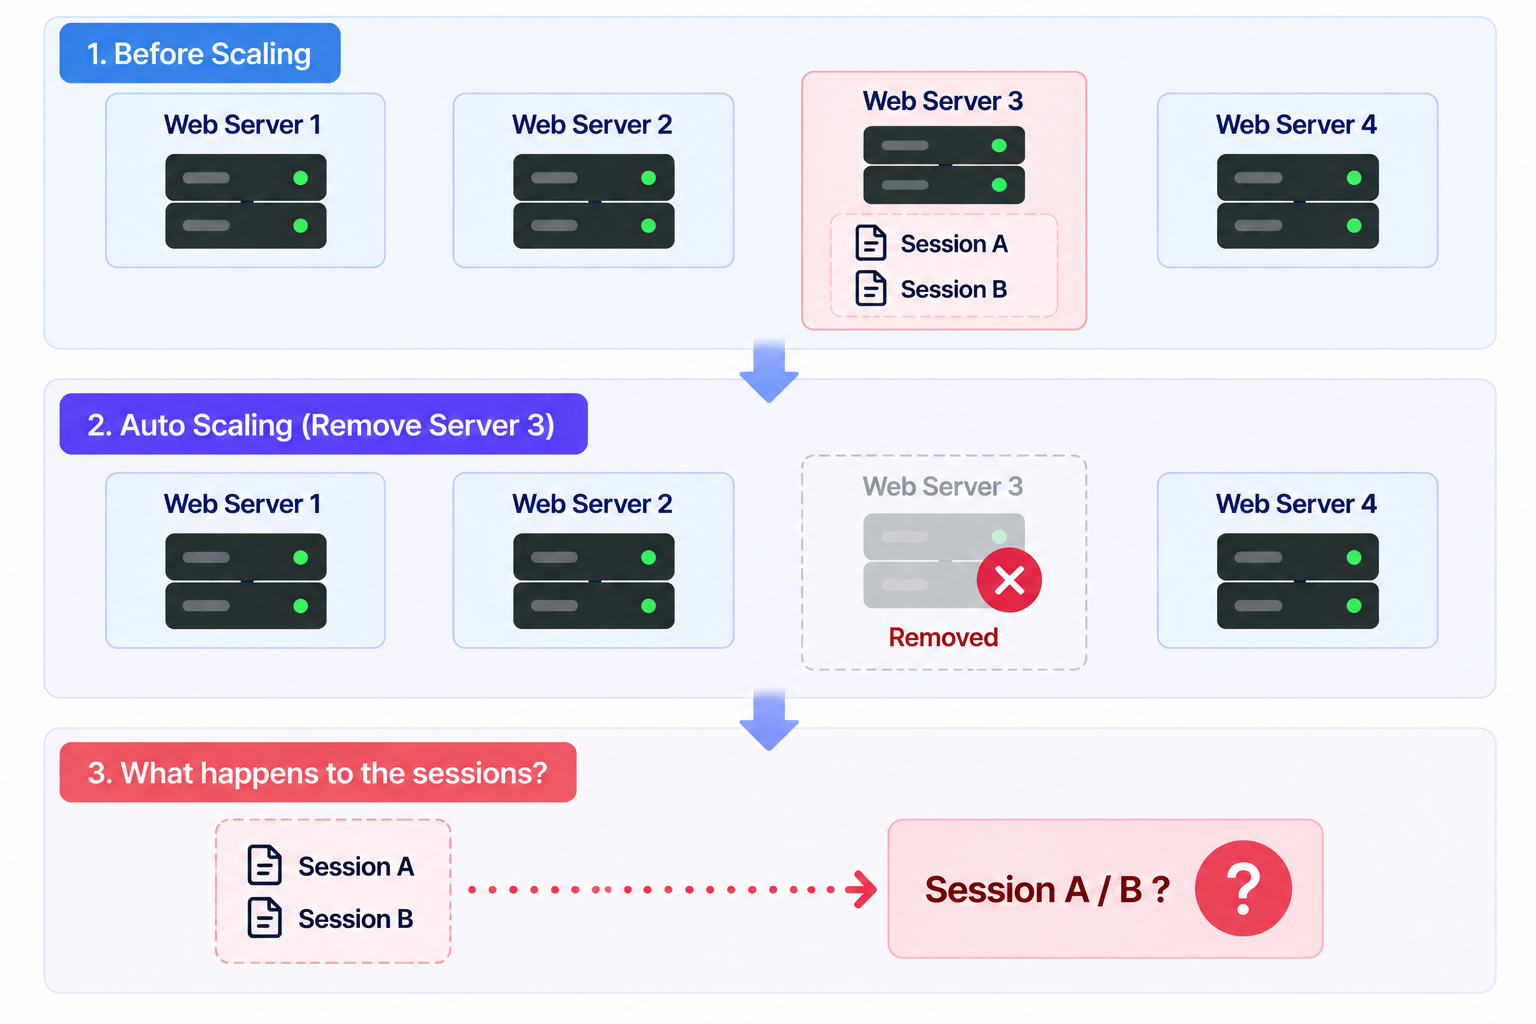
하지만 Web Server가 사용자의 상태(State)를 가지고 있다면 어떨까?
예를 들어 로그인한 사용자의 Session 정보를 각각의 Web Server 메모리에 저장한다고 가정해보자.
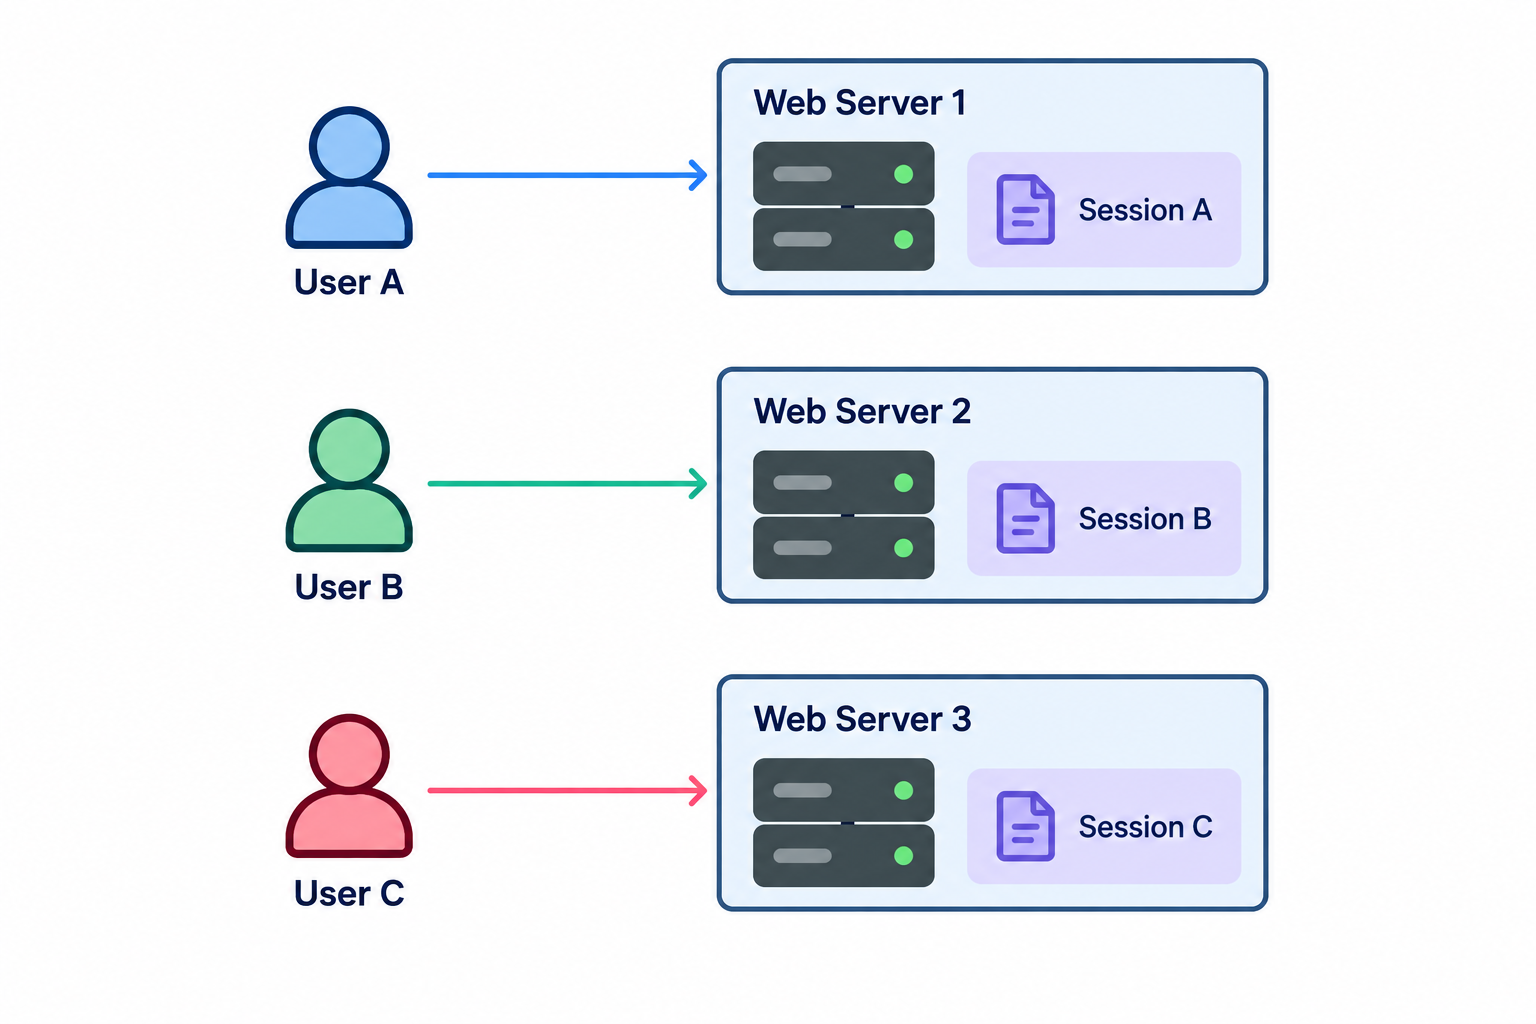
A가 처음 Web Server 1에 접속하여 로그인했다면 User A의 Session 정보는 Web Server 1에 저장된다.
이후 User A의 요청이 다시 Web Server 1로 전달된다면 문제가 없지만, Load Balancer가 다음 요청을 Web Server 2로 전달한다면 어떻게 될까?
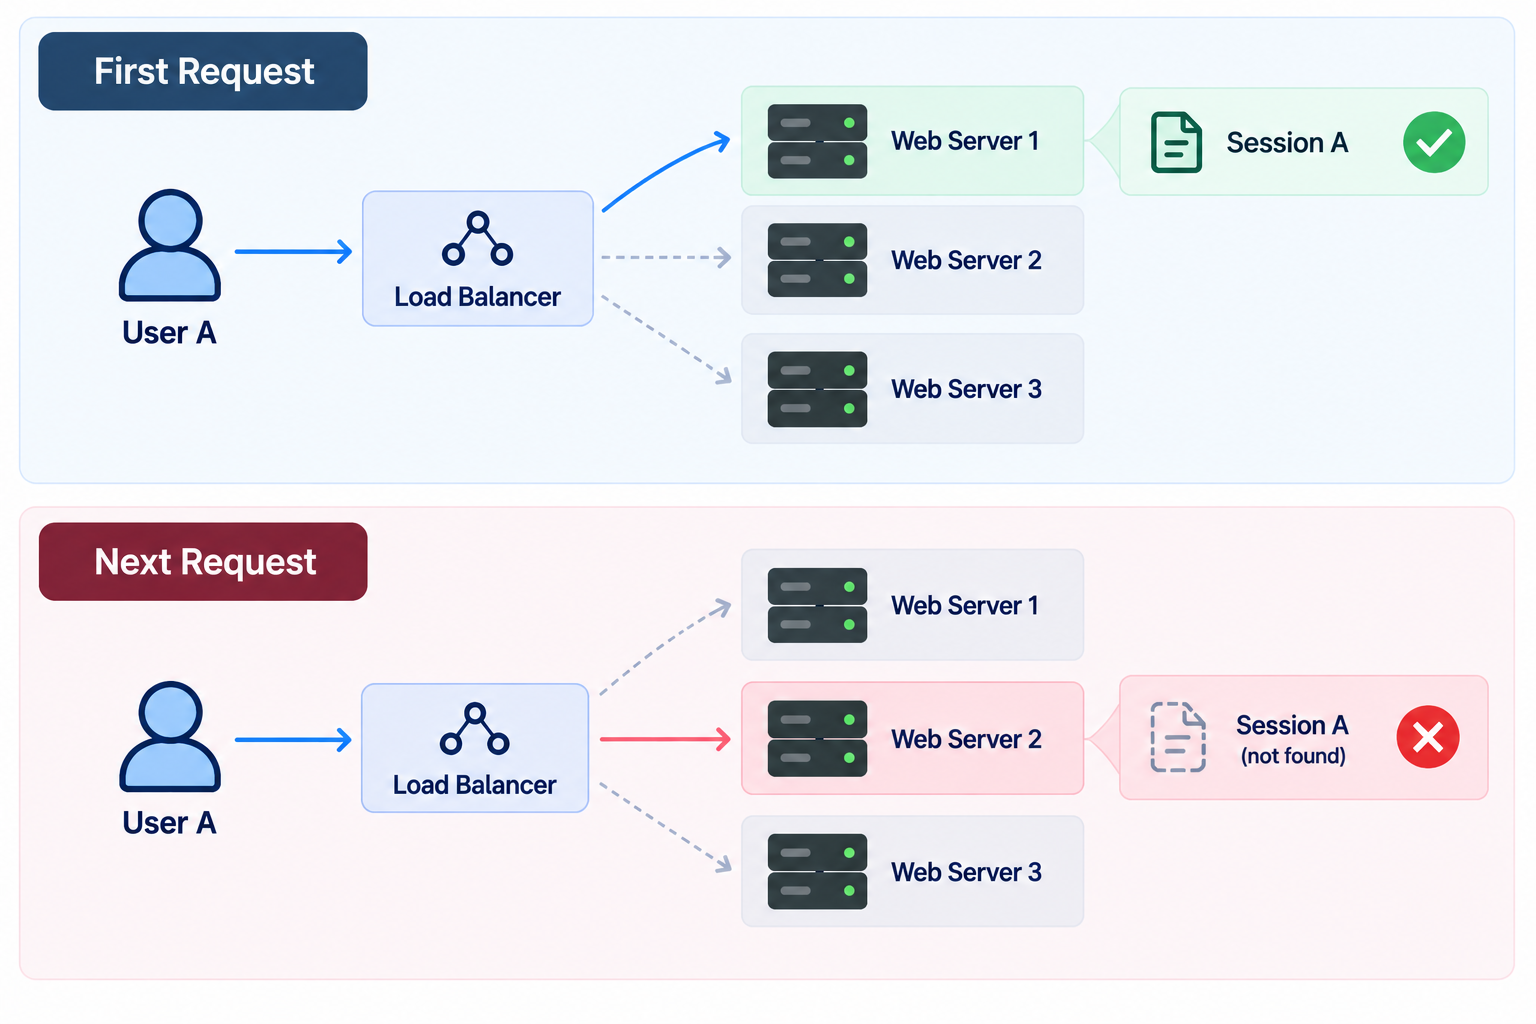
Web Server 2에는 User A의 Session 정보가 존재하지 않기 때문에 사용자의 상태를 정상적으로 확인할 수 없게 된다.
이처럼 서버가 이전 요청에서 발생한 사용자의 상태를 직접 가지고 있는 구조를 Stateful하다고 한다.
Sticky Session
이 문제를 해결하는 간단한 방법 중 하나는 Sticky Session(Session Affinity)을 사용하는 것이다.
Load Balancer가 특정 사용자의 요청을 항상 동일한 Web Server로 전달하도록 하는 방식이다.
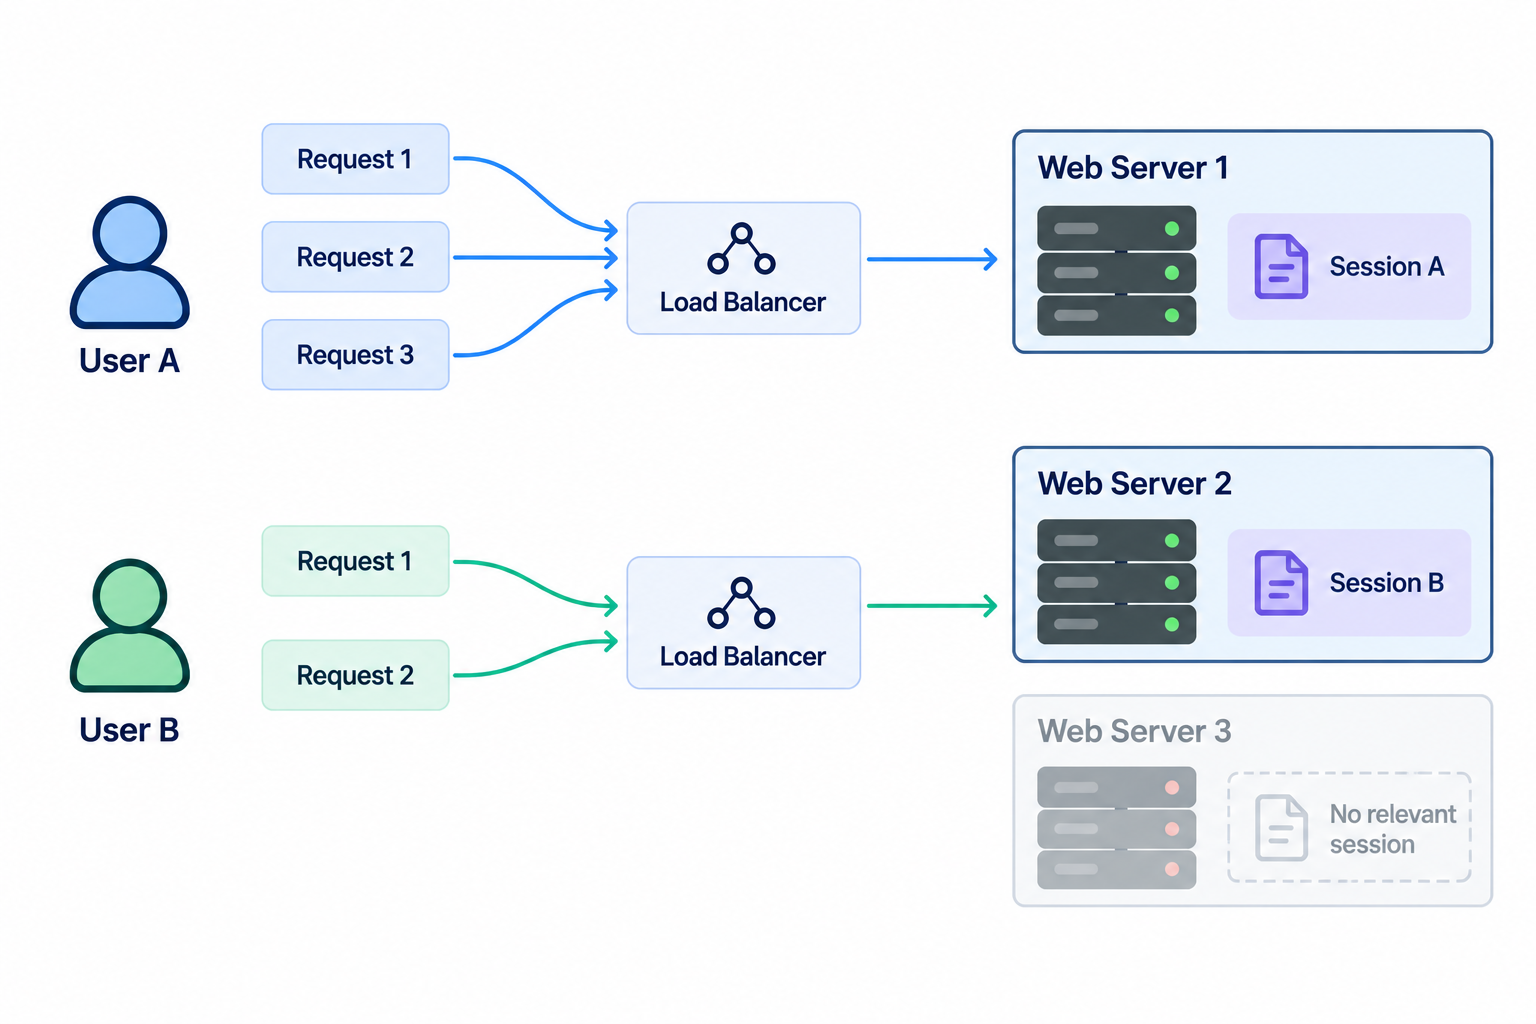
이렇게 하면 Web Server가 Session을 직접 가지고 있어도 사용자의 요청이 계속 같은 서버로 전달되기 때문에 정상적으로 Session을 사용할 수 있다.
하지만 문제가 완전히 해결된 것은 아니다.
예를 들어 User A의 Session을 가지고 있는 Web Server 1에 장애가 발생한다면 User A의 상태 역시 함께 사용할 수 없게 된다.
또한 서버를 추가하거나 제거할 때 특정 사용자가 특정 서버에 종속되어 있다는 점은 자유로운 Scale Out을 어렵게 만든다.
결국 대규모 시스템에서 Web Server를 자유롭게 추가하거나 제거하려면 Web Server 자체가 사용자의 상태를 가지고 있지 않도록 만드는 것이 유리하다.
Stateless
이를 위해 사용자의 상태를 Web Server 외부의 공용 저장소로 이동시킬 수 있다.
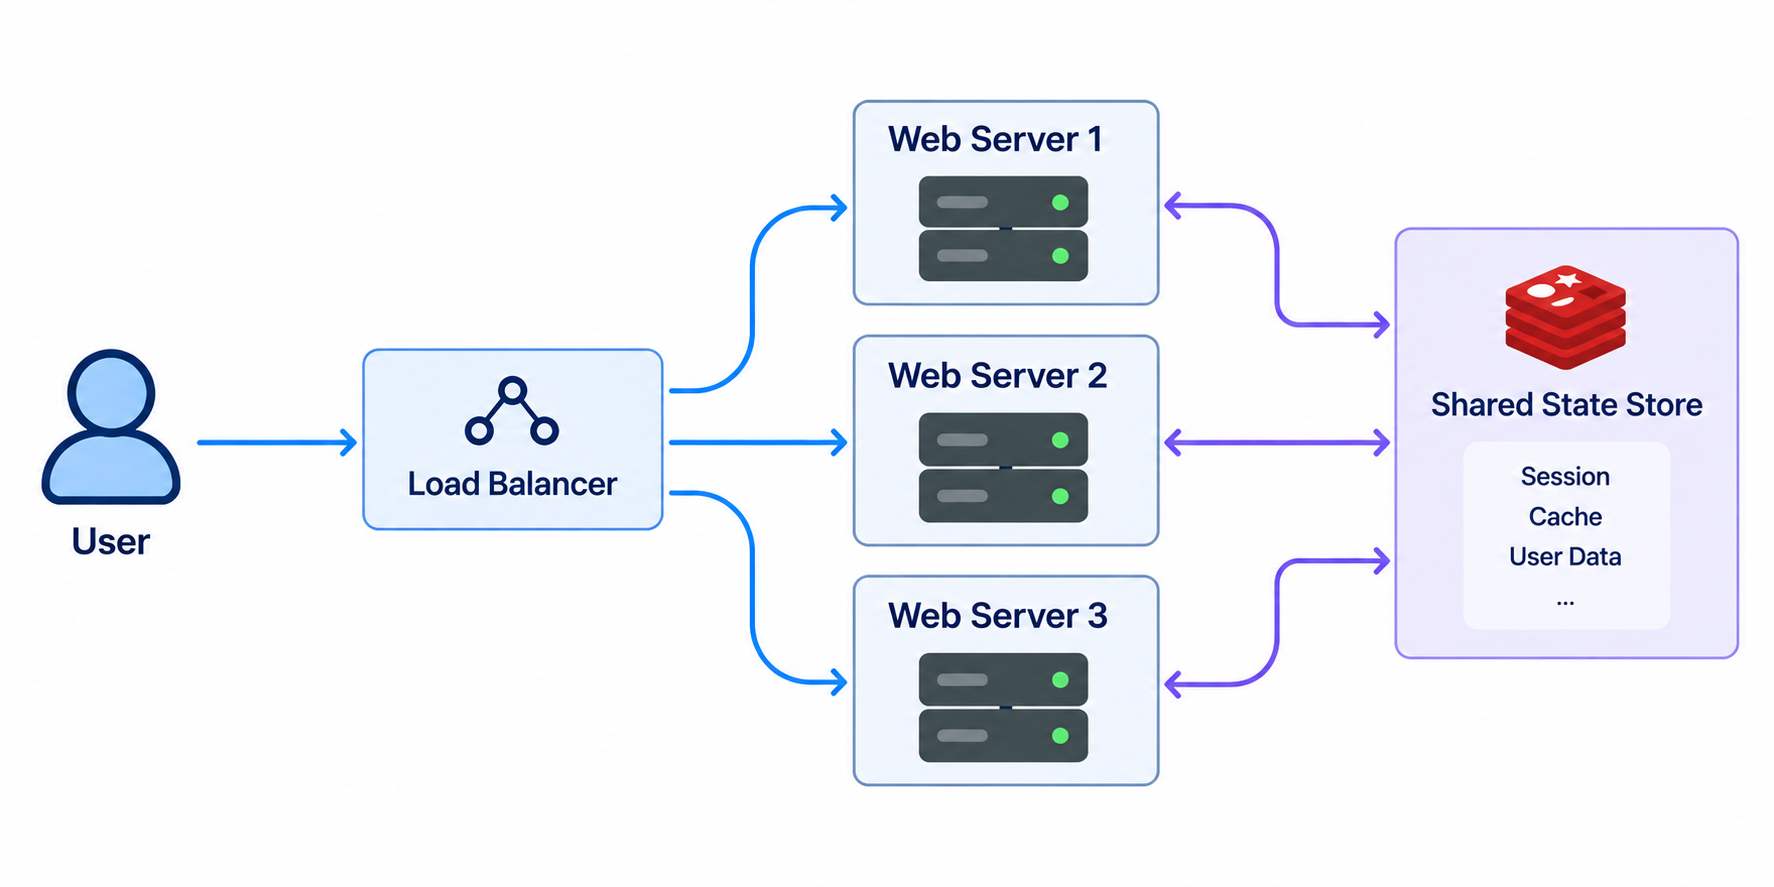
Session과 같은 상태 정보를 Redis, Database 등의 별도 저장소에 보관하고 모든 Web Server가 동일한 저장소에 접근하도록 구성하는 것이다.
이제 User A의 요청이 어느 Web Server로 전달되는지는 중요하지 않다.
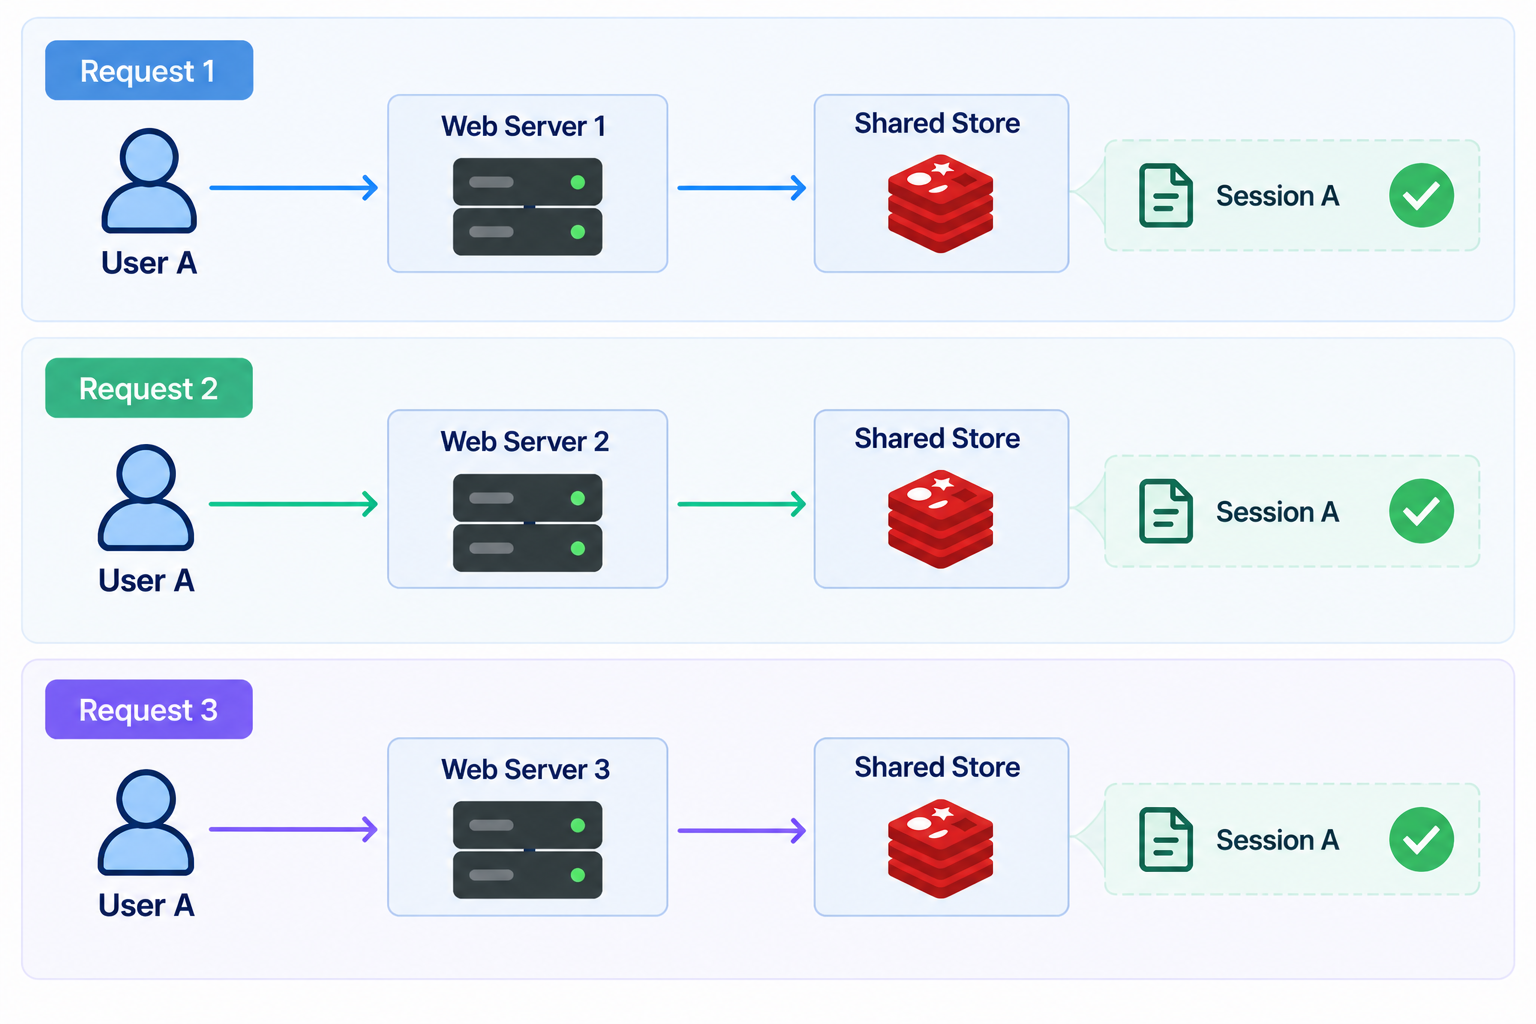
어떤 Web Server가 요청을 처리하더라도 동일한 상태 정보에 접근할 수 있기 때문이다.
이처럼 각각의 Web Server가 클라이언트의 상태를 직접 가지고 있지 않은 구조를 Stateless Web Tier라고 한다.
Stateless 구조가 중요한 이유
Stateless 구조에서는 특정 사용자가 특정 Web Server에 종속되지 않는다.
따라서 Web Server 한 대에 장애가 발생하더라도 다른 Web Server가 요청을 이어서 처리할 수 있고, 트래픽이 증가하면 새로운 Web Server를 추가하는 것도 상대적으로 간단해진다.
반대로 트래픽이 줄어들면 필요하지 않은 Web Server를 제거해도 특정 서버에 저장된 사용자 상태를 함께 잃어버리는 문제가 발생하지 않는다.
결국 이전 글에서 살펴봤던 Scale Out을 보다 자유롭게 하기 위해서는 Web Tier를 Stateless하게 구성하는 것이 중요하다.
그리고 여기까지 오면 한 가지 생각을 해볼 수 있다.
트래픽이 증가할 때 Web Server를 자유롭게 추가하고, 트래픽이 감소하면 다시 제거할 수 있다면 이를 사람이 직접 할 필요가 있을까?
트래픽에 따라 필요한 만큼 서버를 자동으로 추가하거나 제거하는 것이 Auto Scaling이다.
Auto Scaling
앞에서 Web Server가 사용자의 상태를 직접 가지고 있지 않도록 Stateless한 구조로 변경했다.
이제 특정 사용자가 특정 Web Server에 종속되지 않기 때문에 필요에 따라 Web Server를 추가하거나 제거하기가 훨씬 쉬워졌다.
그렇다면 한 가지 더 생각해볼 수 있다.
트래픽이 증가할 때마다 사람이 직접 서버를 추가하고, 트래픽이 줄어들면 다시 서버를 제거해야 할까?
이를 자동화하기 위해 사용할 수 있는 것이 Auto Scaling이다.
Auto Scaling은 트래픽이나 서버의 상태에 따라 필요한 서버의 수를 자동으로 늘리거나 줄이는 방식이다.
예를 들어 평소에는 2대의 Web Server만으로 충분한 서비스가 있다고 가정해보자.
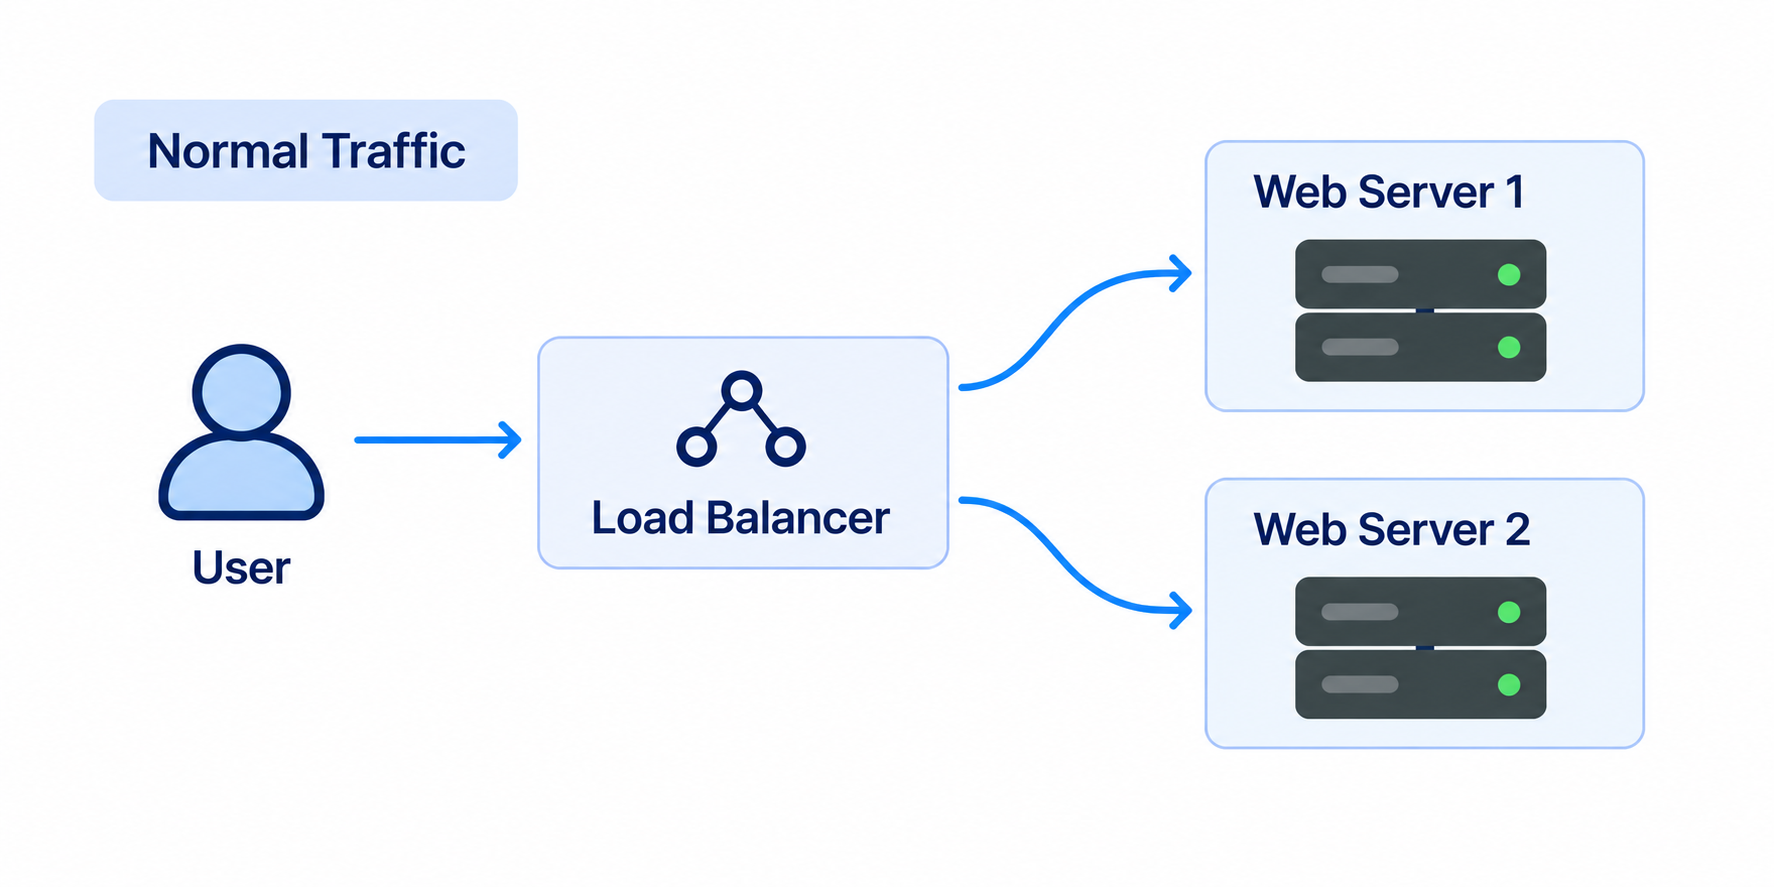
그런데 특정 이벤트나 프로모션으로 인해 갑자기 사용자가 증가한다면 기존 서버만으로 모든 요청을 처리하기 어려워질 수 있다.
이때 새로운 Web Server를 자동으로 추가하여 트래픽을 분산할 수 있다.

반대로 사용자가 다시 줄어들면 필요하지 않은 Web Server를 제거할 수 있다.
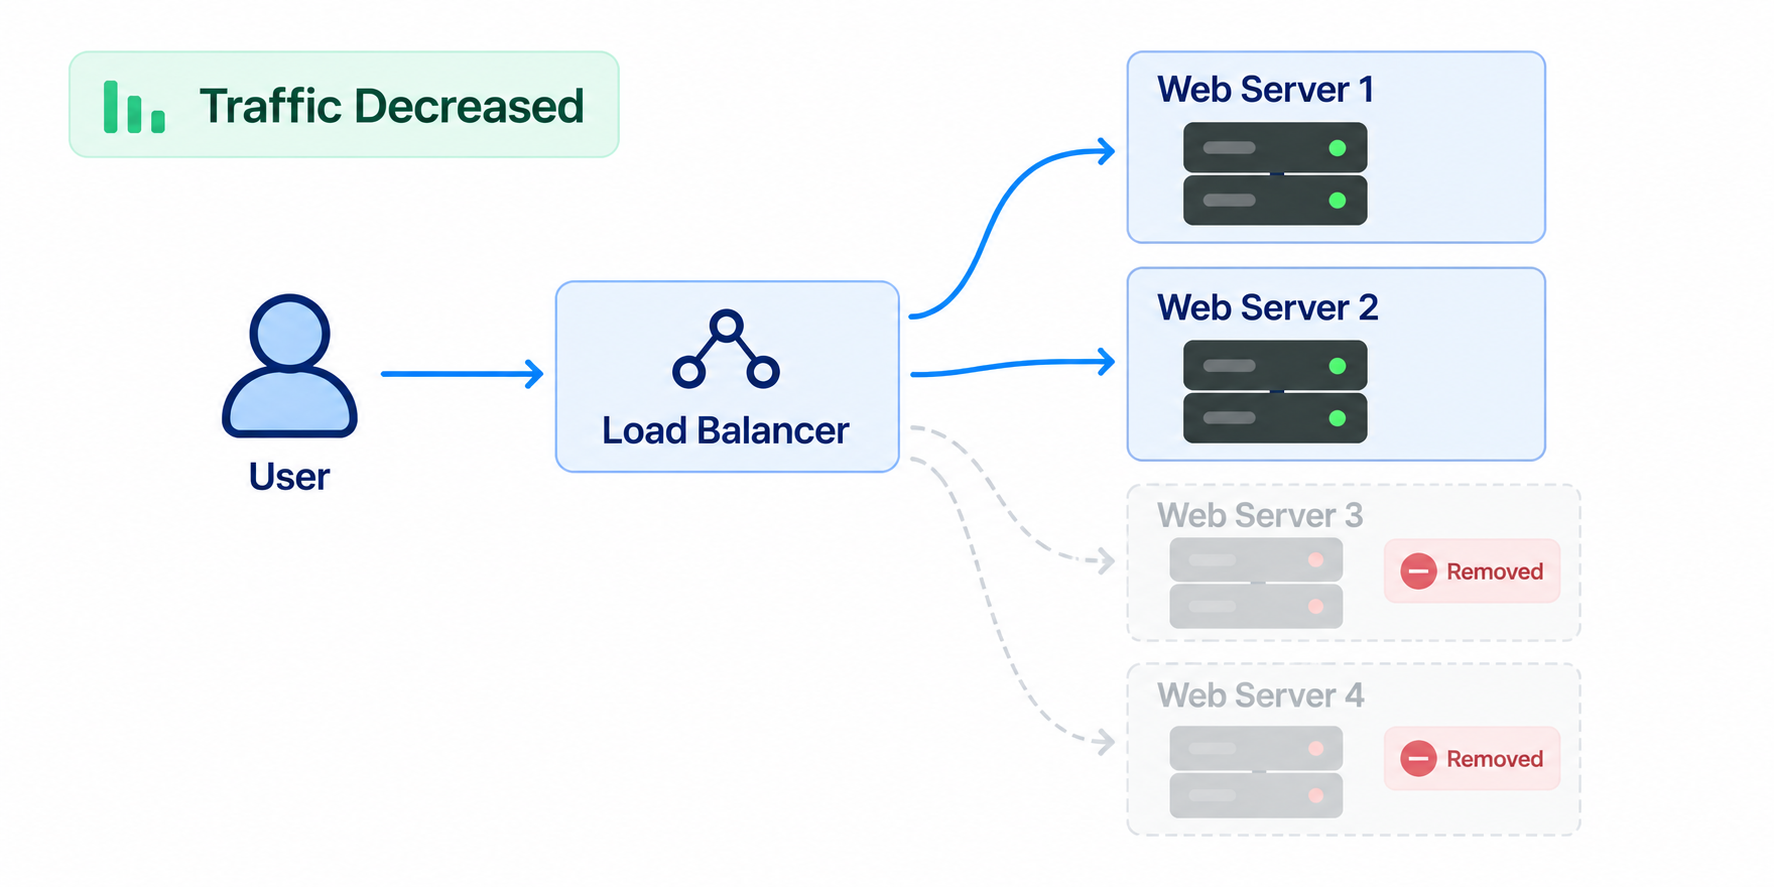
이를 통해 트래픽이 많을 때는 처리할 수 있는 서버의 수를 늘리고, 트래픽이 적을 때는 서버의 수를 줄여 불필요한 인프라
비용을 줄일 수 있다.
언제 서버를 늘리고 줄일까?
Auto Scaling이라고 해서 단순히 사용자의 수만 보고 서버를 추가하는 것은 아니다.
실제 환경에서는 다양한 지표를 기준으로 Scaling 정책을 설정할 수 있다.
예를 들어 CPU 사용률을 기준으로 CPU 사용률이 일정 시간 동안 70% 이상이라면 Web Server를 추가한다.
또는 CPU 사용률이 일정 시간 동안 30% 이하라면 Web Server를 제거한다.
와 같은 정책을 만들 수 있다.
CPU뿐만 아니라 Memory 사용량, Request 수, Network 사용량, Queue의 크기 등 서비스의 특성에 맞는
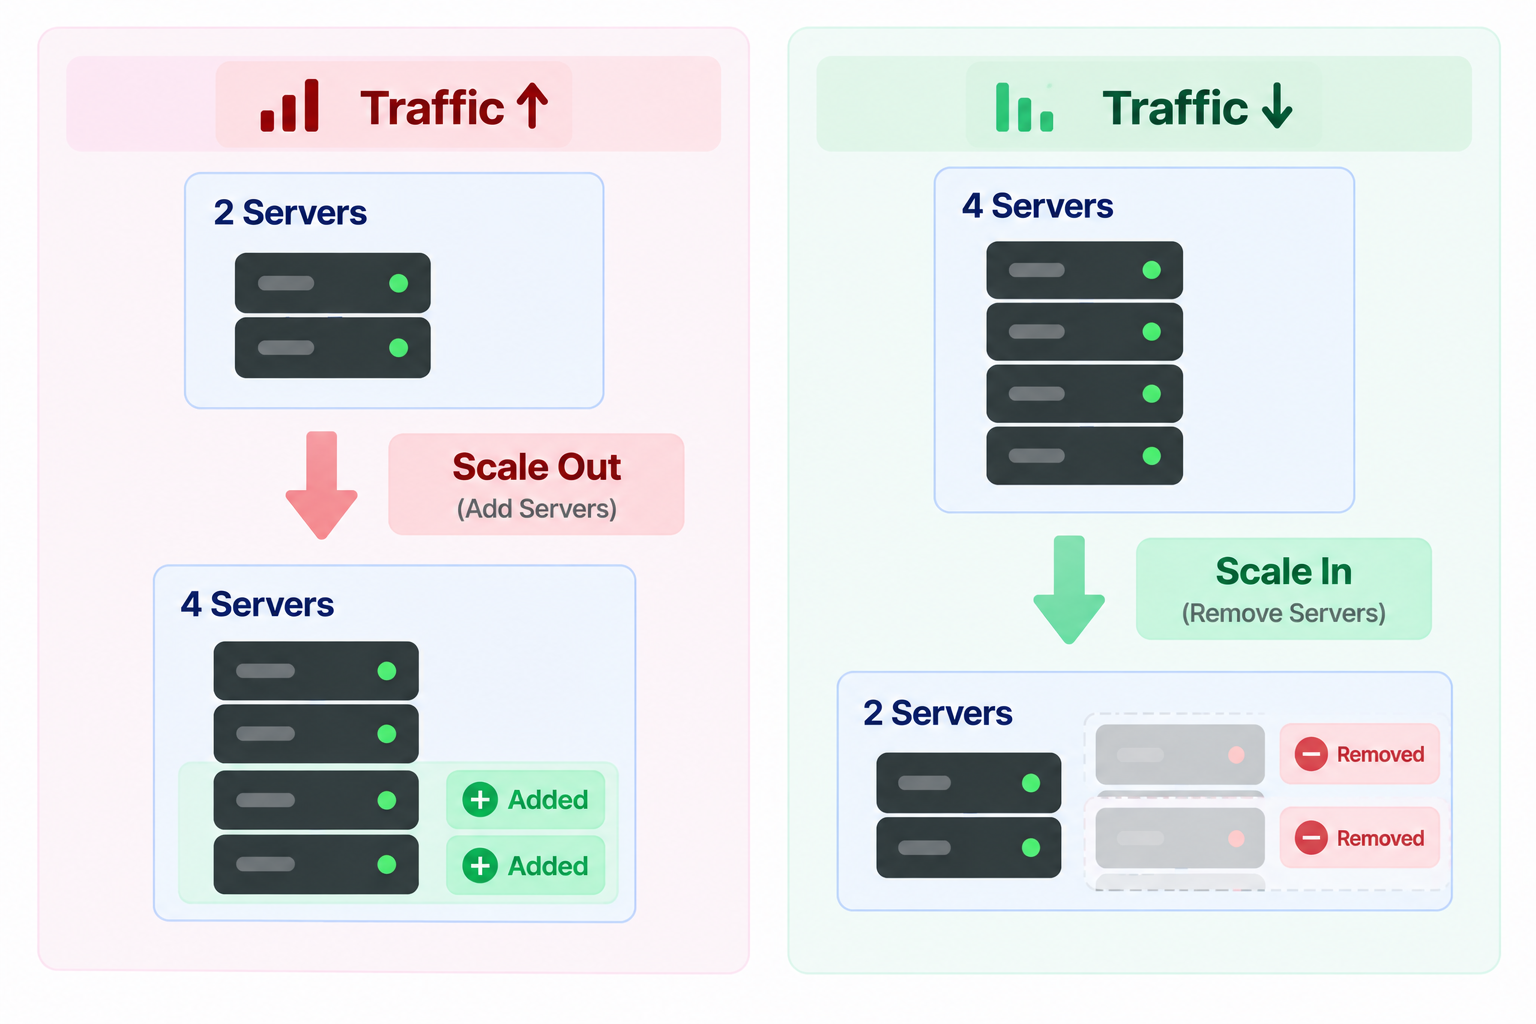
지표를 사용할 수도 있다. 이때 서버의 수를 늘리는 것을 Scale Out, 서버의 수를 줄이는 것을 Scale In이라고 한다.
Stateless가 중요한 이유
앞에서 Stateless Web Tier를 먼저 살펴본 이유도 여기에 있다.
만약 각각의 Web Server가 사용자 Session을 직접 가지고 있다면 Auto Scaling으로 서버를 마음대로 제거하기 어렵다.
반면 Session과 같은 상태를 Shared Store로 분리했다면 Web Server 자체는 상태를 가지고 있지 않다.
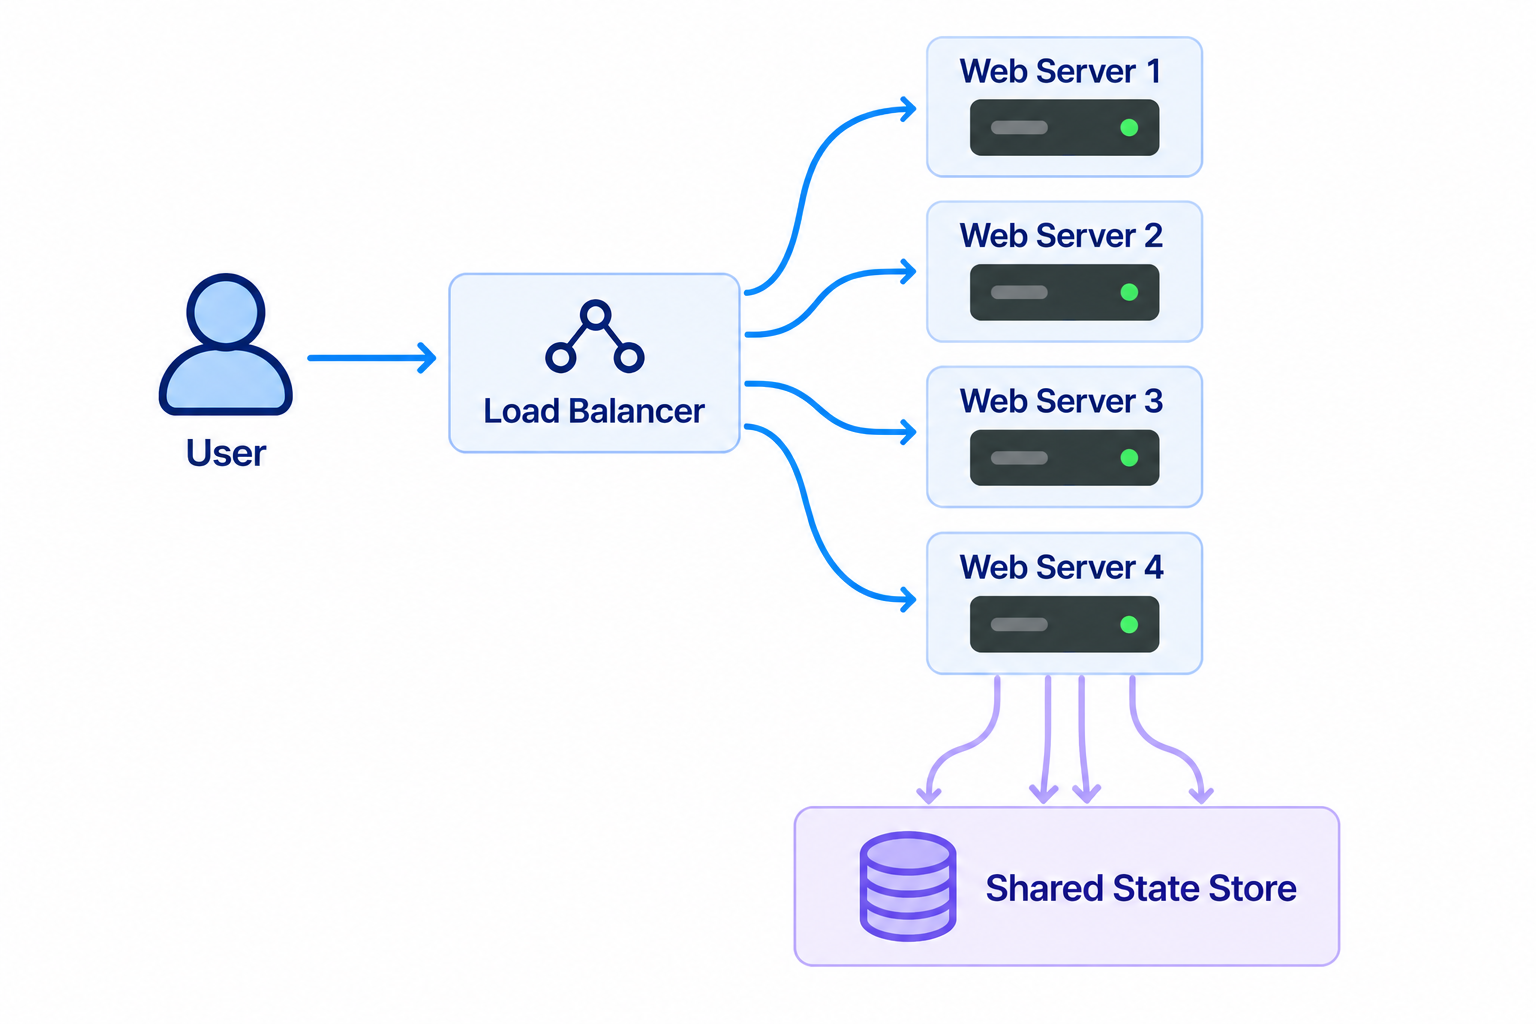
따라서 필요에 따라 Web Server를 추가하거나 제거하더라도 사용자의 상태가 특정 서버와 함께 사라지는 문제가 발생하지 않는다.
결국 Stateless한 구조는 Web Tier를 유연하게 Auto Scaling하기 위한 중요한 기반이 된다.
하지만 서버를 계속 늘리면 끝일까?
여기까지 구성하면 트래픽이 증가하더라도 Web Server의 수를 자동으로 늘려 대응할 수 있게 되었다.
하지만 지금까지의 구조에는 여전히 한 가지 큰 가정이 있다.
모든 인프라가 하나의 지역에 존재한다는 것이다.
Web Server를 10대, 100대로 늘리더라도 해당 서버들이 위치한 Data Center나 Region 전체에 장애가 발생한다면 서비스를 정상적으로 제공하기 어려울 수 있다.
또한 사용자가 한국뿐만 아니라 미국, 유럽 등 여러 지역으로 늘어난다면 하나의 지역에서 모든 요청을 처리하는 것이 네트워크 지연 측면에서도 불리할 수 있다.
이를 해결하기 위해 다음으로 Multi Data Center 구조를 살펴보자.
Data Centers
Stateless Web Tier와 Auto Scaling을 적용하면서 트래픽의 변화에 따라 Web Server를 자유롭게 추가하거나 제거할 수 있게 되었다.
하지만 서버의 개수를 아무리 늘리더라도 모든 서버가 하나의 Data Center에 존재한다면 또 다른 문제가 발생할 수 있다.
예를 들어 모든 인프라가 하나의 지역에 구성되어 있다고 가정해보자.
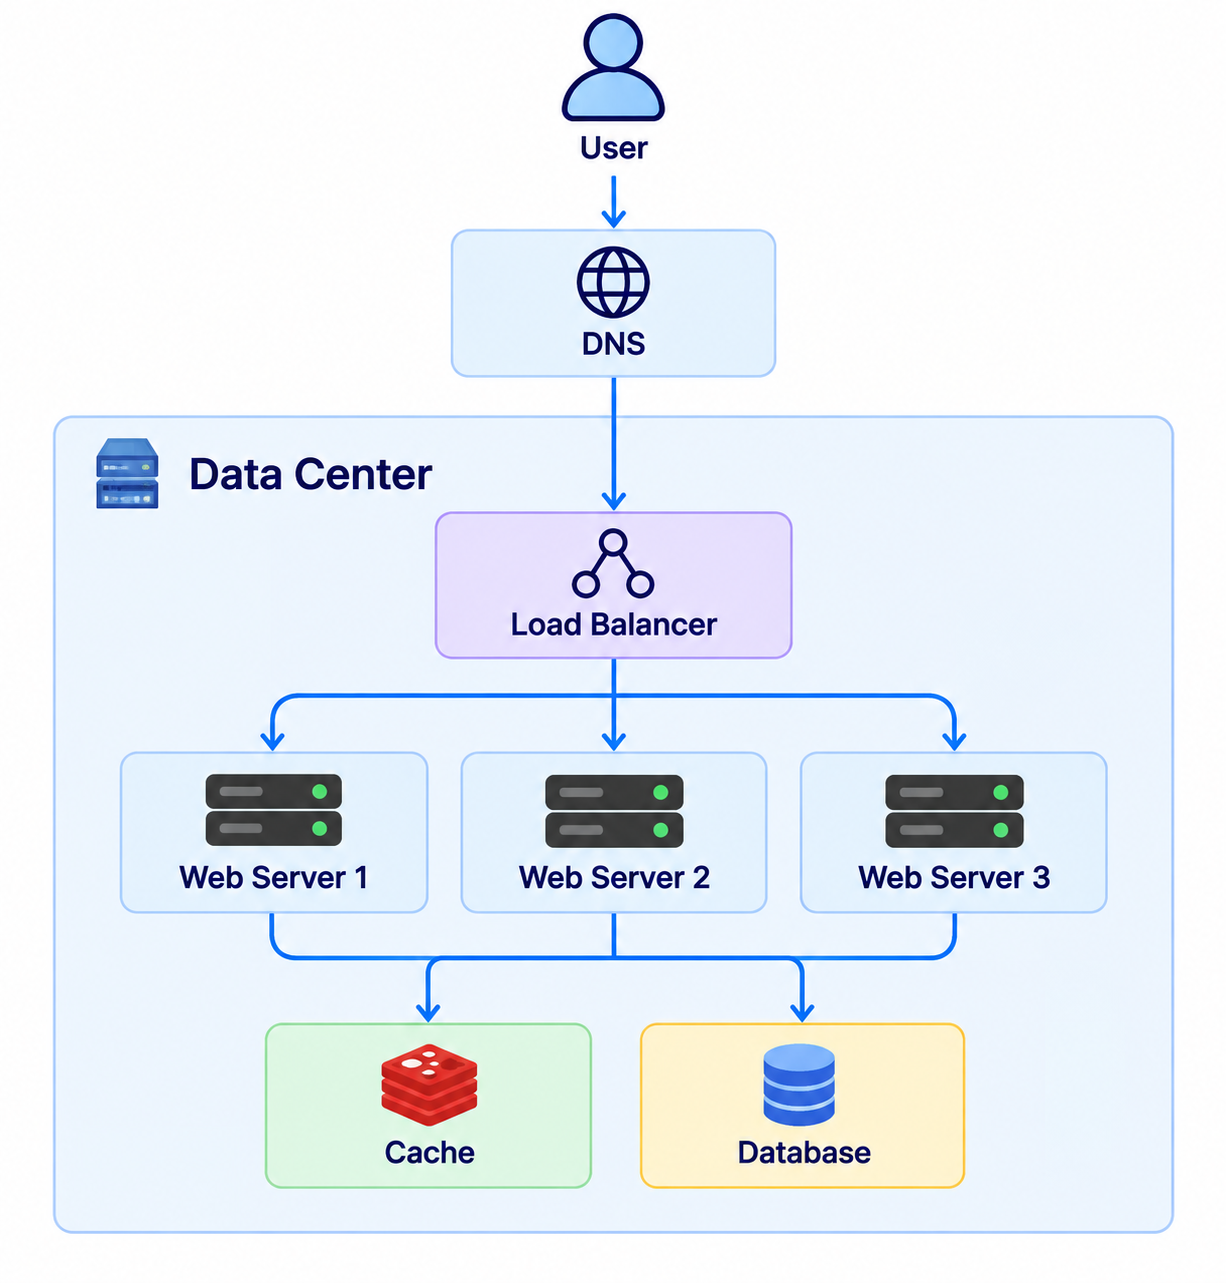
Web Server 한 대에 장애가 발생하는 것은 앞에서 구성한 Load Balancer와 Auto Scaling 등을 통해 대응할 수 있다.
하지만 네트워크 장애나 정전, 자연재해와 같이 Data Center 전체에 영향을 주는 장애가 발생한다면 내부에 Web Server를 아무리 많이 구성해 놓더라도 서비스를 정상적으로 제공하기 어렵다.
또한 서비스의 사용자가 여러 국가로 늘어난다면 사용자와 Data Center 사이의 물리적인 거리 역시 문제가 될 수 있다.
한국에만 Data Center가 있는데 미국이나 유럽의 사용자가 계속해서 한국까지 요청을 보내야 한다면 그만큼 네트워크 지연 시간이 증가할 수 있다.
이를 해결하기 위해 여러 지역에 Data Center를 구성할 수 있다.
Multi Data Center
예를 들어 미국 동부와 서부 두 지역에 Data Center를 구성했다고 가정해보자.
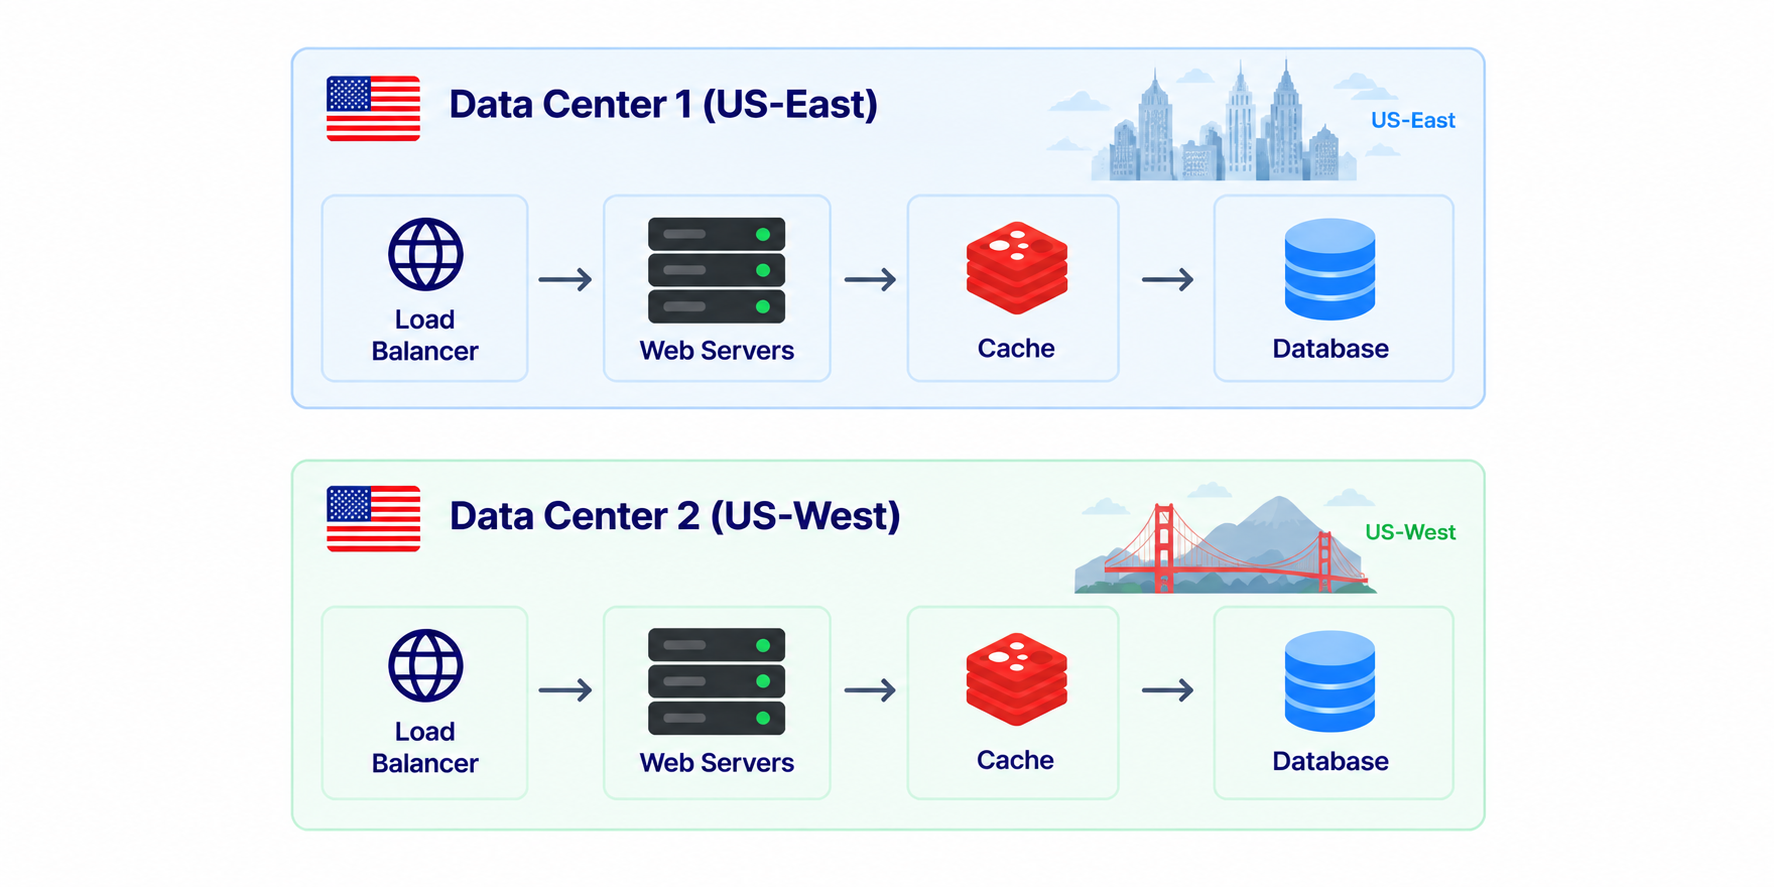
각 Data Center는 독립적으로 요청을 처리할 수 있도록 Web Server, Cache, Database 등의 인프라를 구성한다.
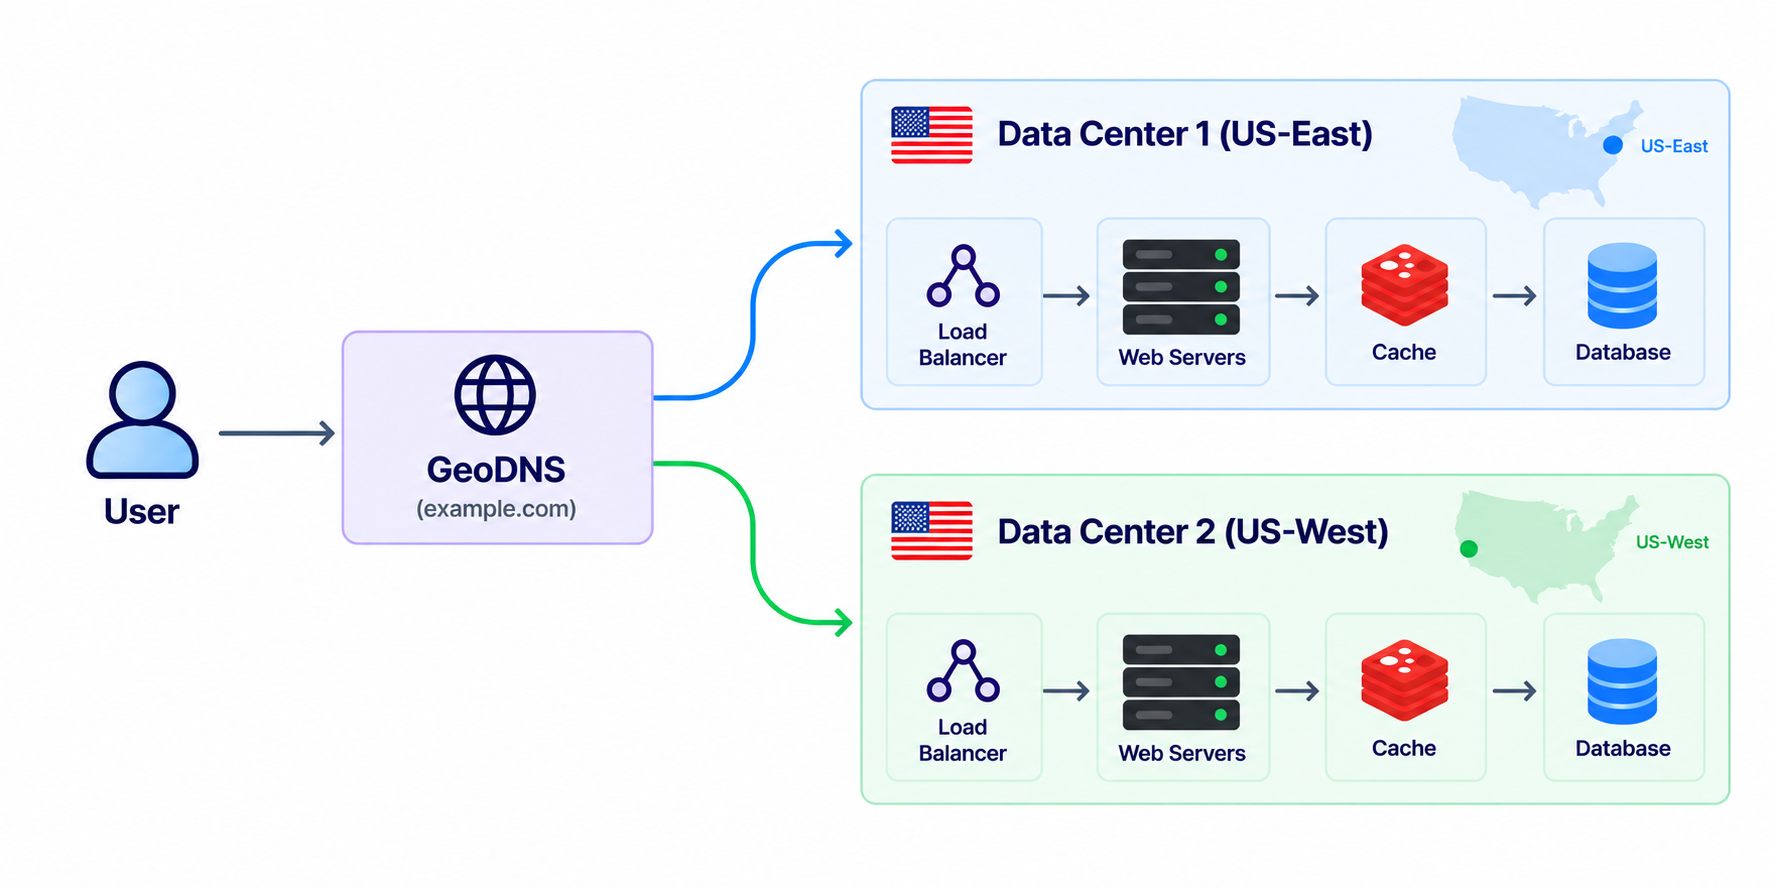
이때 사용자의 위치에 따라 가까운 Data Center로 요청을 전달하기 위해 GeoDNS(Geographical DNS)를 사용할 수 있다.
일반적인 DNS가 Domain에 해당하는 IP 주소를 반환한다면, GeoDNS는 사용자의 위치 등을 기준으로 서로 다른 IP 주소를 반환하도록 구성할 수 있다.
예를 들어 미국 동부에 있는 사용자는 US-East로, 미국 서부에 있는 사용자는 US-West로 요청을 전달하는 방식이다.
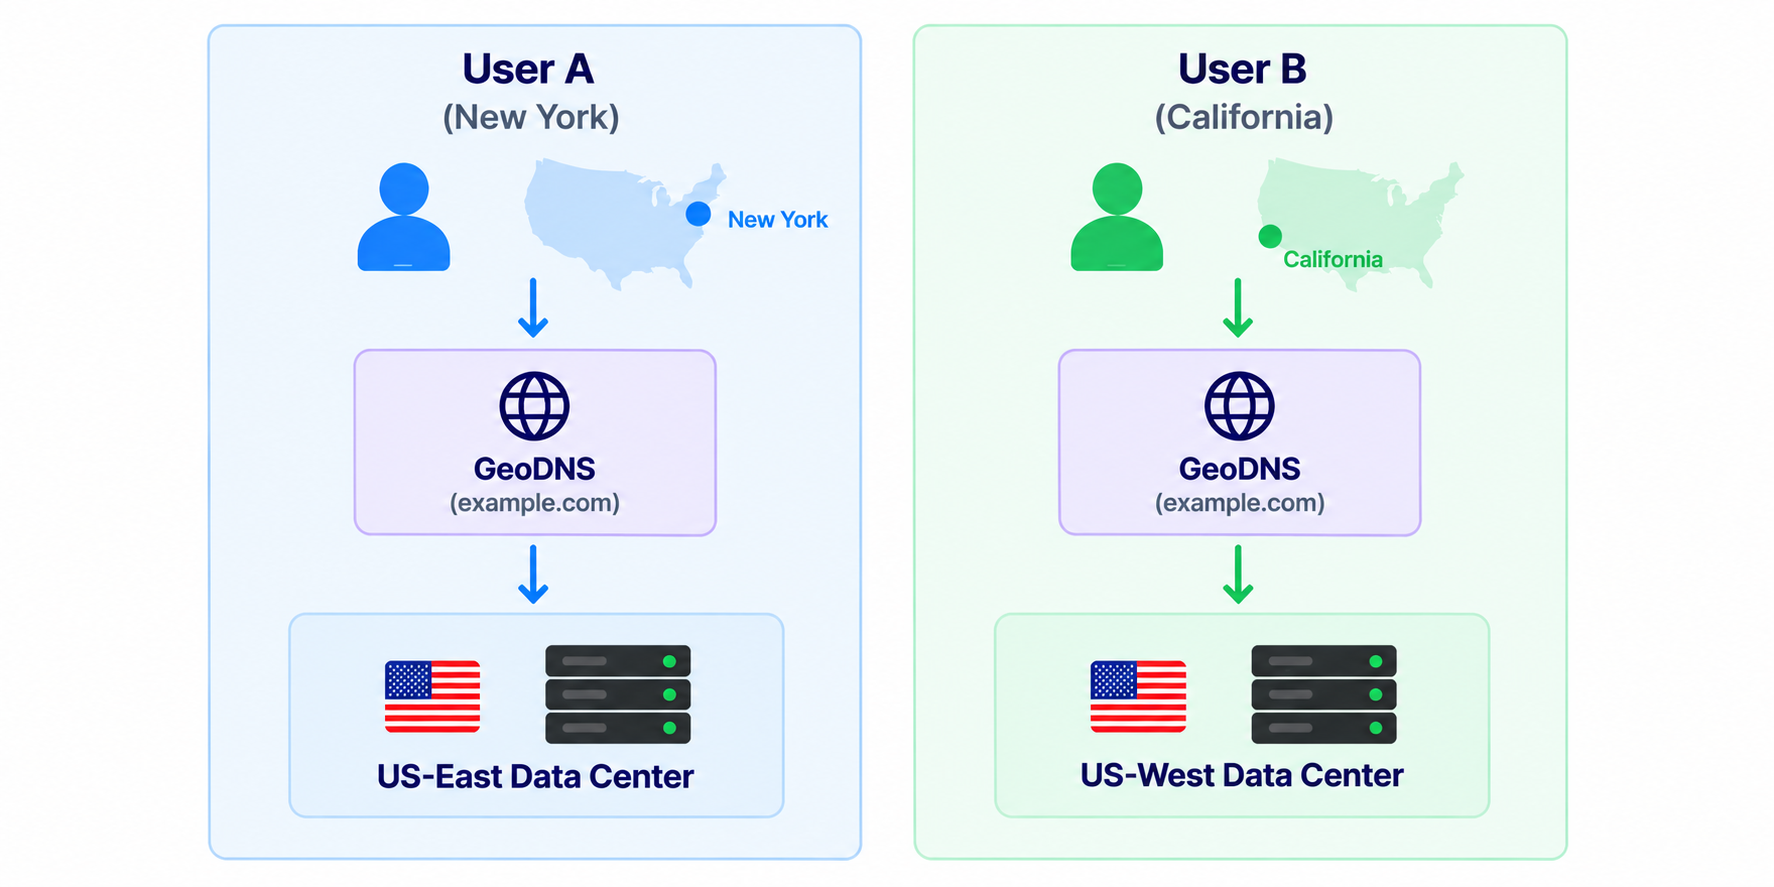
이를 통해 사용자는 상대적으로 가까운 Data Center에서 서비스를 제공받을 수 있고, 하나의 Data Center에 모든 트래픽이 집중되는 것도 줄일 수 있다.
Data Center에 장애가 발생하면?
Multi Data Center 구조의 또 다른 장점은 Data Center 단위의 장애에도 대응할 수 있다는 점이다.
평상시에는 두 Data Center가 트래픽을 나누어 처리하고 있다고 가정해보자.
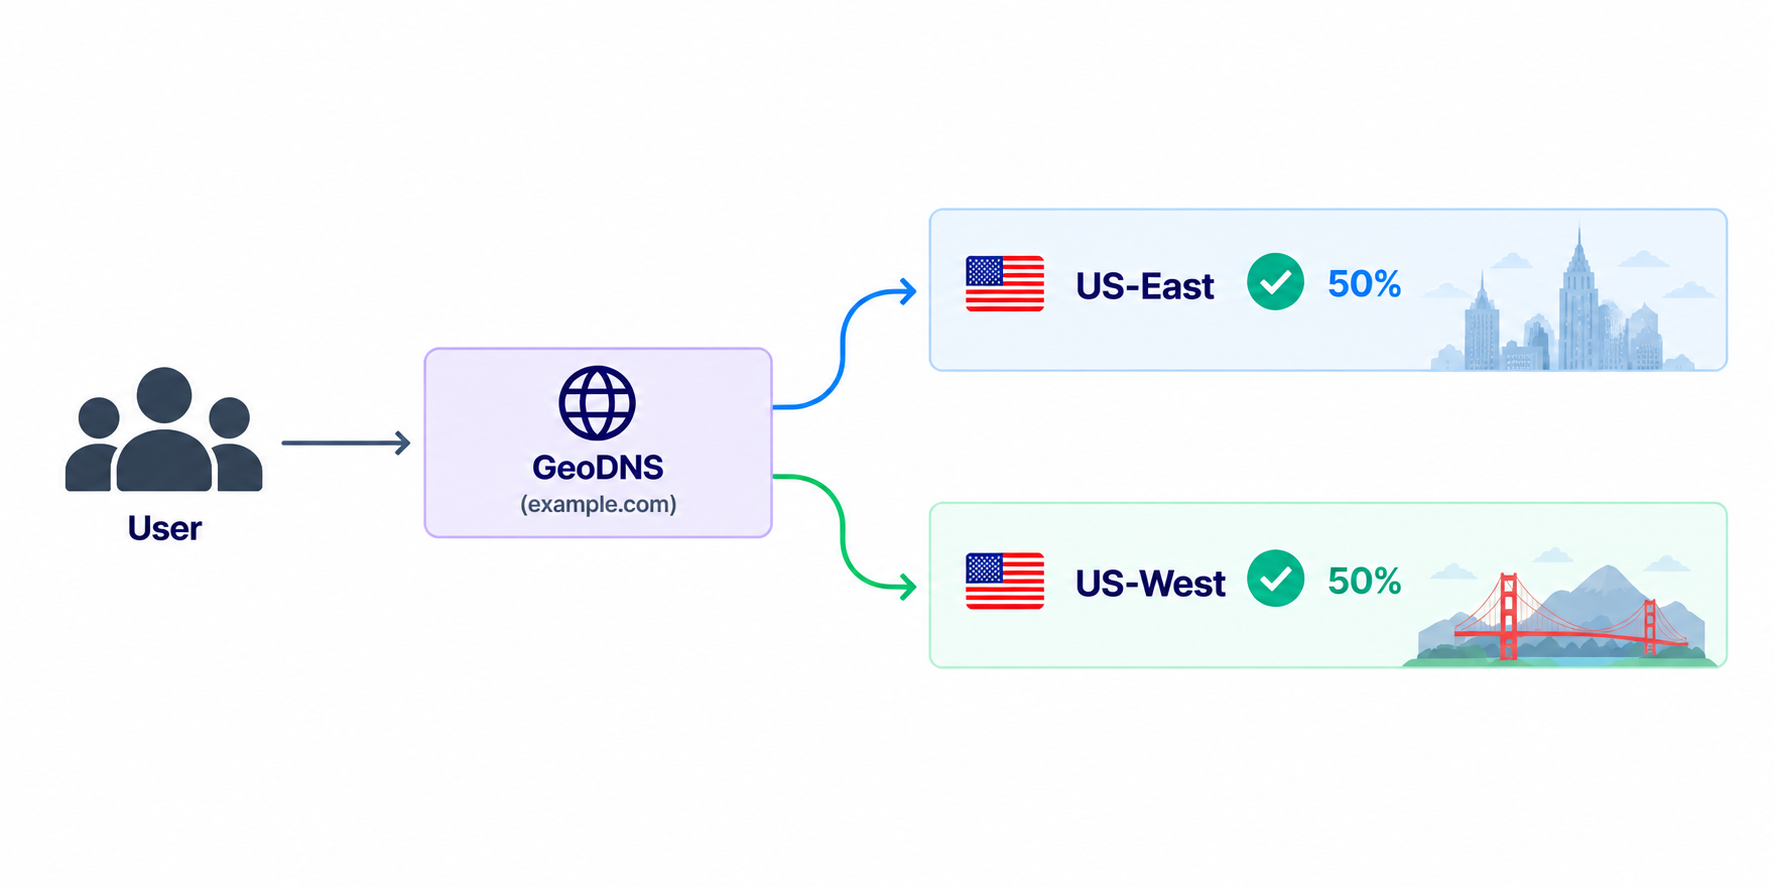
그런데 US-West Data Center 전체에 장애가 발생한다면 해당 지역으로 보내던 요청을 정상적으로 동작하는 US-East로 전달할 수 있다.
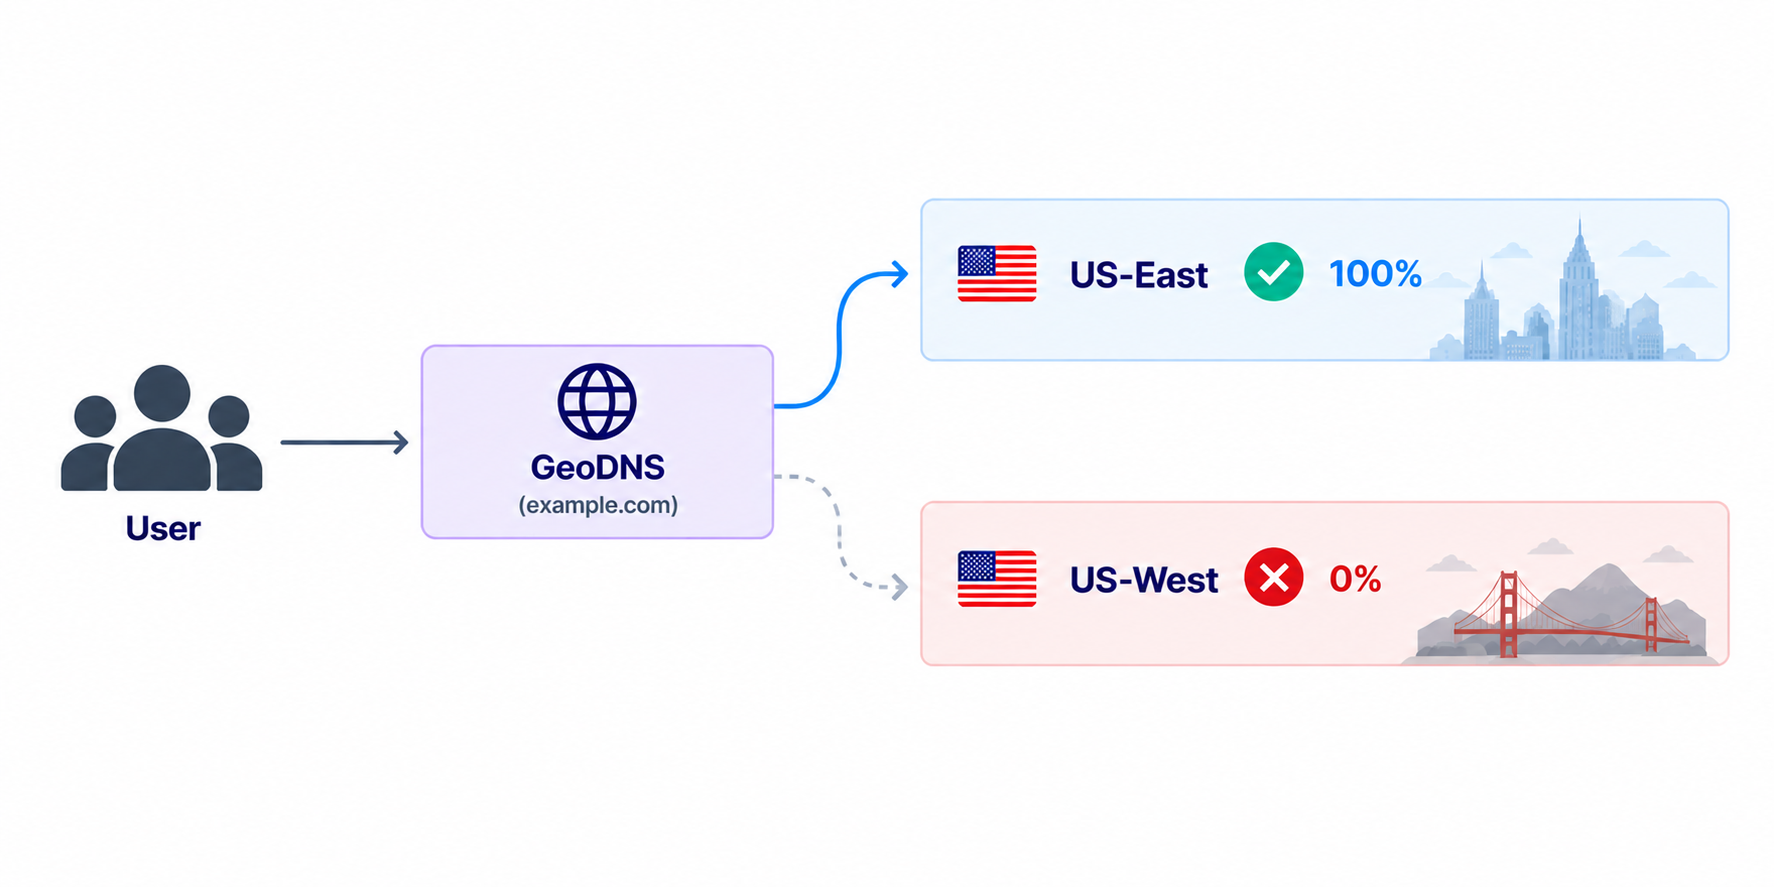
이렇게 하면 하나의 Data Center 전체에 장애가 발생하더라도 다른 Data Center에서 서비스를 계속 제공할 수 있다.
앞에서 Web Server 하나의 장애를 여러 서버를 통해 대응했다면, 이제는 장애 대응의 범위를 Data Center 단위까지 확장한 것이라고 볼 수 있다.
Multi Data Center라고 해서 단순히 서버를 복사하면 끝일까?
물론 여러 지역에 동일한 서버를 배치한다고 해서 모든 문제가 해결되는 것은 아니다.
오히려 시스템이 여러 지역으로 나뉘면서 새로운 문제들이 발생한다.
대표적으로 Traffic Routing, Data Synchronization, Deployment 등을 고려해야 한다.
Traffic Routing은 어떤 사용자를 어떤 Data Center로 보낼 것인지 결정하는 문제다. 앞에서 살펴본 GeoDNS 등을 이용하여 사용자와 가까운 지역이나 현재 정상적으로 동작하는 Data Center로 요청을 전달할 수 있다.
더 어려운 문제는 Data Synchronization이다.
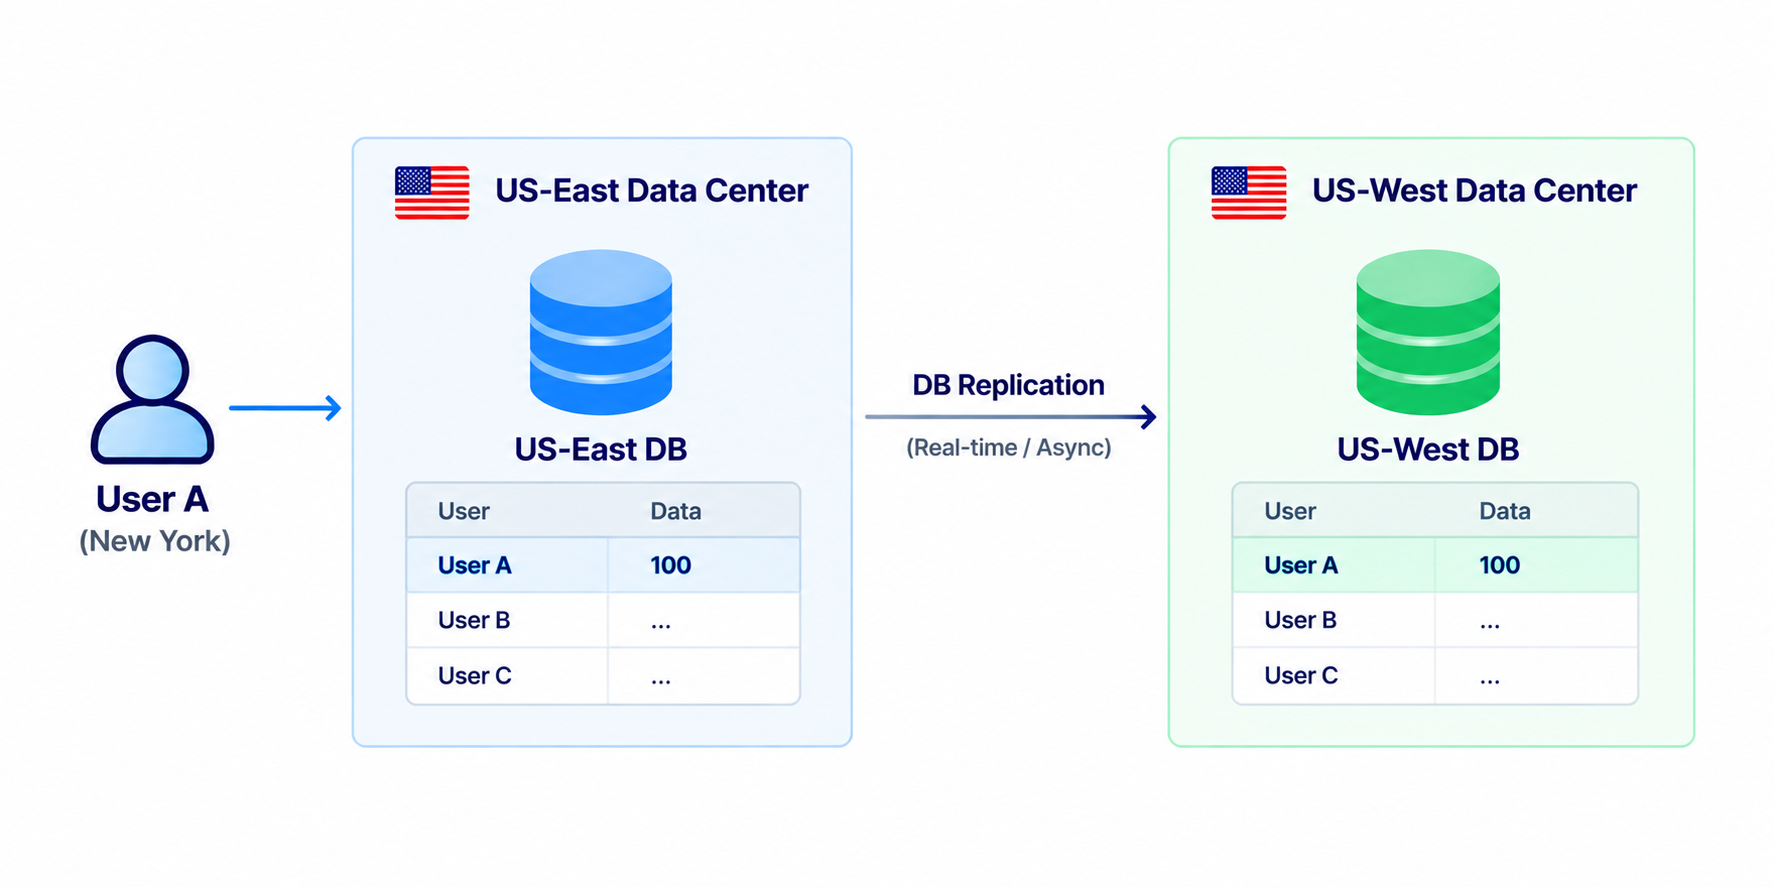
한 지역에서 데이터가 변경되었다면 다른 지역에서도 동일한 데이터를 사용할 수 있어야 한다.
특히 한 Data Center에 장애가 발생하여 다른 Data Center로 트래픽을 넘겼는데 해당 지역에 최신 데이터가 존재하지 않는다면 정상적으로 서비스를 이어갈 수 없다.
따라서 지역 간 Database Replication과 데이터 일관성 등을 함께 고려해야 한다.
마지막으로 Deployment 역시 중요해진다.
Data Center가 하나라면 한 곳에만 애플리케이션을 배포하면 되지만 여러 Data Center를 운영한다면 모든 지역에 동일한 버전의 애플리케이션과 설정이 배포될 수 있도록 자동화하는 것이 중요해진다.
이번 글에서는 Multi Data Center 자체를 깊게 다루기보다는 서비스의 규모가 커지면서 서버 단위의 장애 대응을 넘어 지역 단위의 장애와 지연 시간까지 고려하게 된다는 정도로 이해하고 넘어가려고 한다.
여기까지 오면서 Web Server, Cache, Database 등 시스템을 구성하는 요소들이 점점 많아졌다.
시스템의 규모가 더 커지면 각각의 구성 요소가 서로 직접 의존하는 구조 역시 문제가 될 수 있다.
특정 작업을 처리하는 서버에 장애가 발생하거나 처리 속도가 느려진다면 요청을 보낸 서버까지 영향을 받을 수 있기 때문이다.
각각의 구성 요소를 독립적으로 확장하고, 서로 간의 의존성을 낮추기 위해 사용할 수 있는 방법 중 하나가 Message Queue이다.
지금까지는 트래픽이 증가하면서 발생하는 문제를 해결하기 위해 Web Server를 늘리고, Database를 분리하고, 여러 Data Center를 구성하는 방식으로 시스템을 확장해왔다.
하지만 시스템의 규모가 커지면서 각각의 컴포넌트가 많아지면 컴포넌트 간의 의존성 역시 새로운 문제가 될 수 있다.
예를 들어 사용자가 이미지를 업로드하면 이미지의 크기를 조절하고 여러 포맷으로 변환하는 기능이 있다고 가정해보자.
Web Server에서 이미지 처리를 직접 수행한다면 다음과 같은 구조가 될 수 있다.
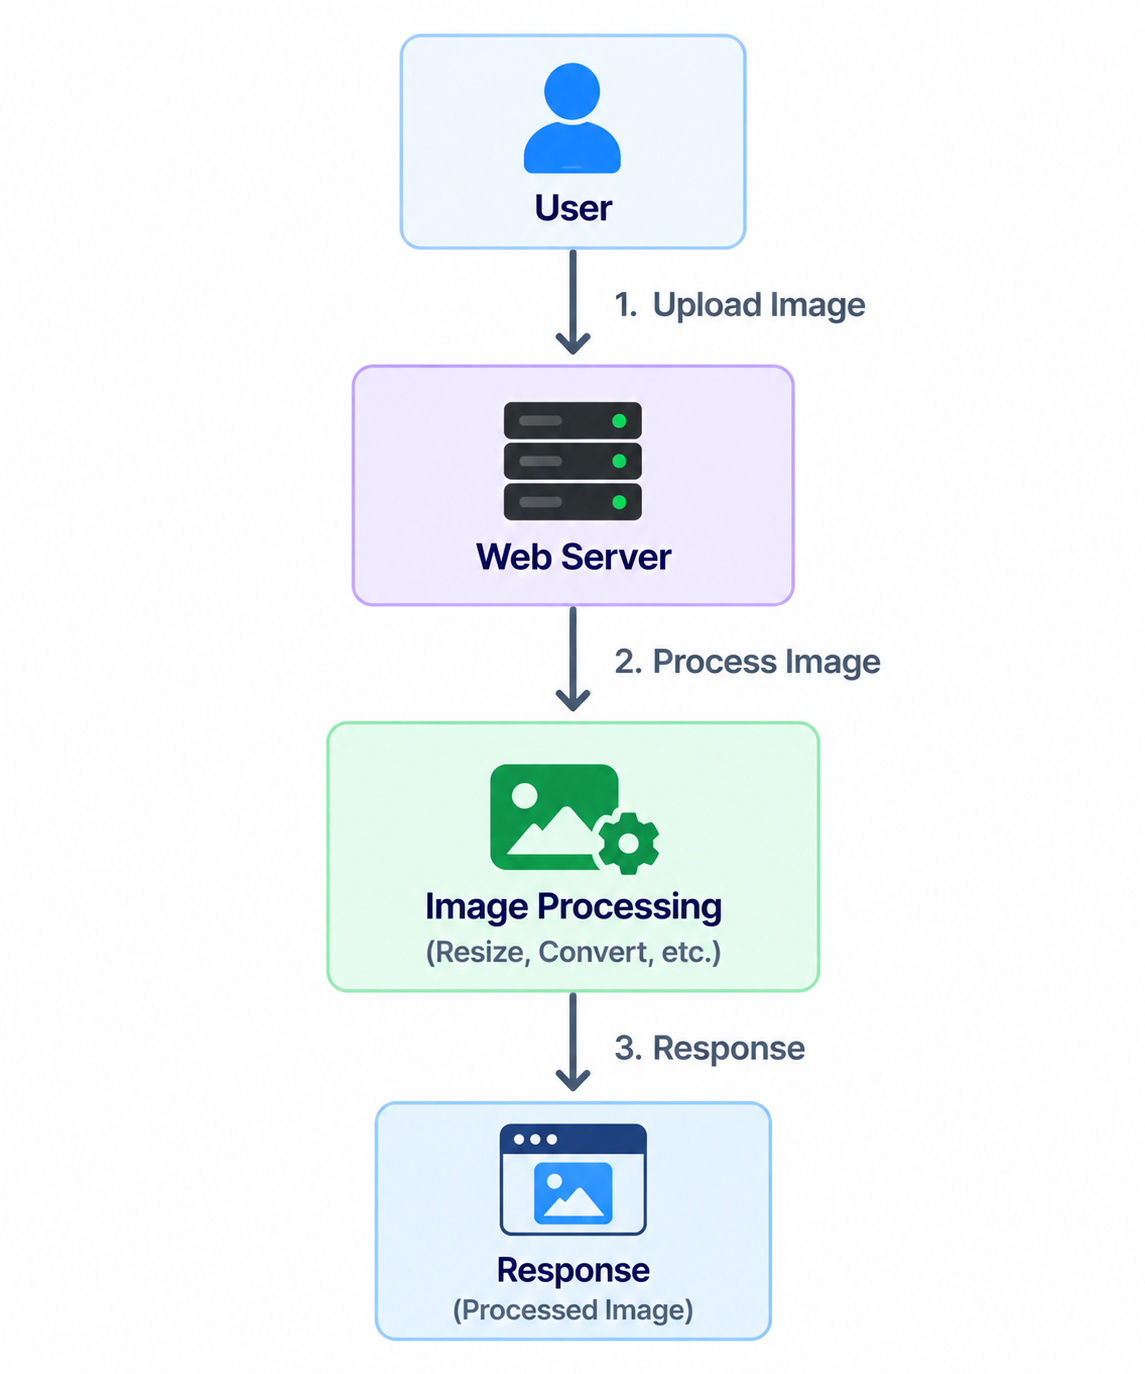
이미지 처리가 5초가 걸린다면 Web Server 역시 해당 작업이 끝날 때까지 기다려야 한다.
이미지 처리 서버의 속도가 느려지거나 장애가 발생한다면 요청을 보낸 Web Server에도 영향을 줄 수 있다.
무엇보다 사용자가 많아지면서 이미지 처리 요청이 갑자기 증가하면 Web Server와 이미지 처리 시스템 모두 순간적으로 큰 부하를 받을 수 있다.
이러한 컴포넌트 간의 의존성을 줄이기 위해 Message Queue를 사용할 수 있다.
Message Queue
Message Queue는 처리해야 할 작업을 바로 실행하는 대신 Message의 형태로 Queue에 저장해두고 다른 시스템이 이를 가져가 처리할 수 있도록 하는 중간 계층이다. 기본적인 구조는 간단하다.

Message를 만들어 Queue에 전달하는 쪽을 Producer(Publisher), Queue에서 Message를 가져와 실제 작업을 수행하는 쪽을 Consumer(Subscriber)라고 한다.
예를 들어 앞에서 이야기한 이미지 처리 기능에 Message Queue를 적용해보자.
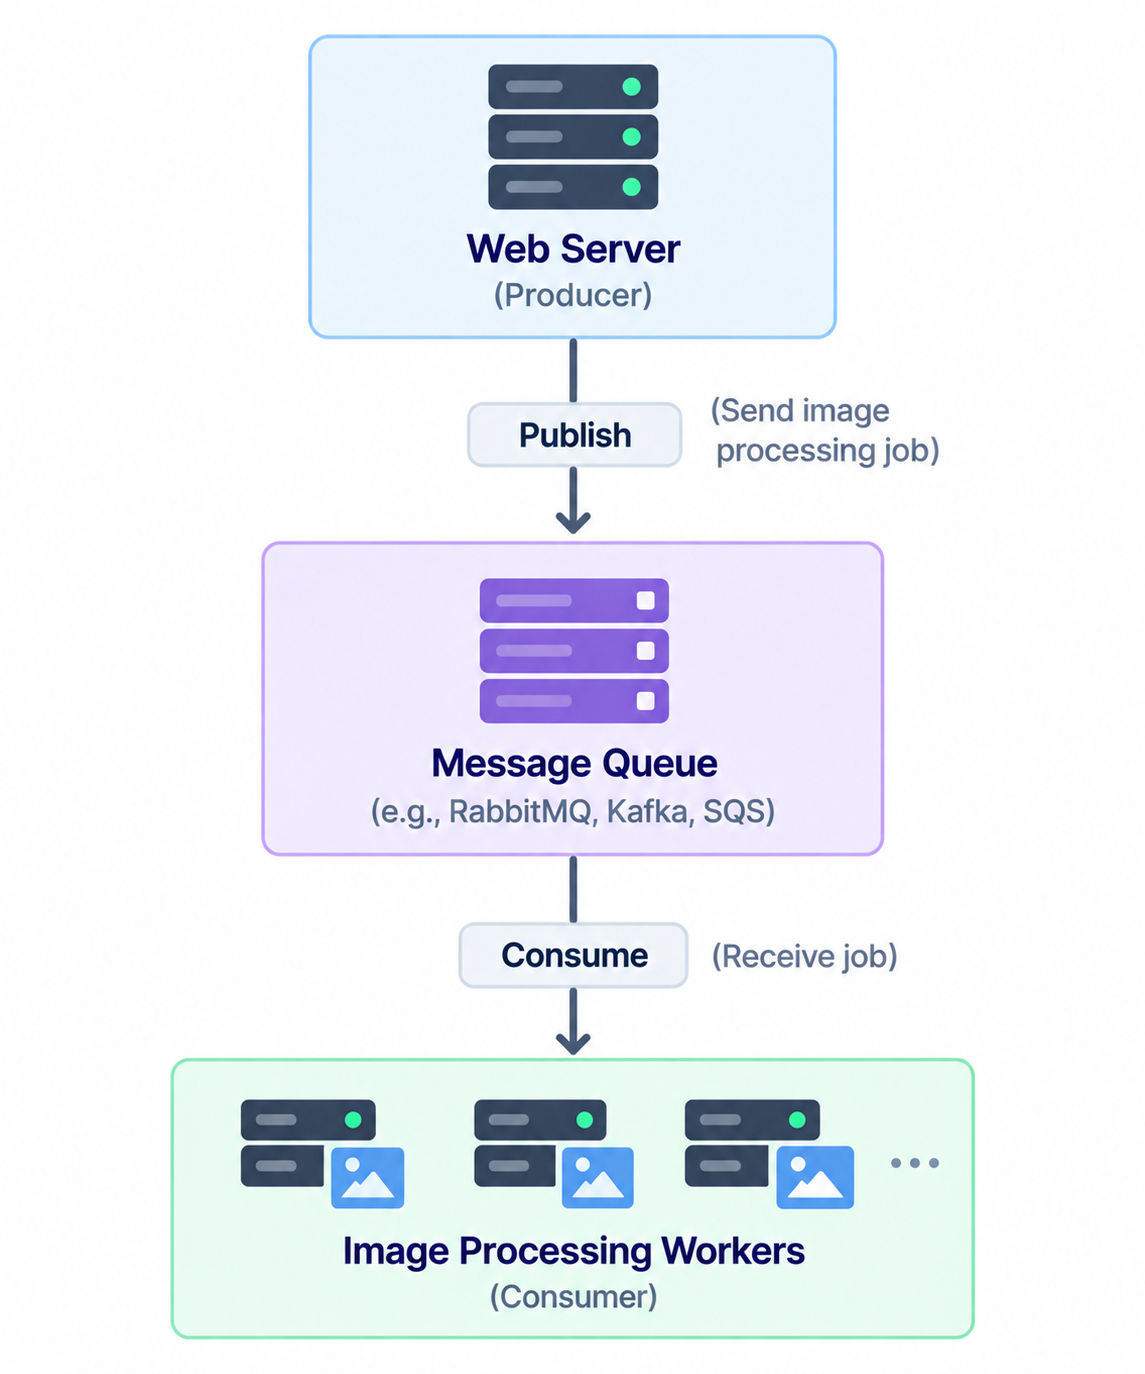
사용자가 이미지를 업로드하면 Web Server가 직접 이미지 처리가 끝날 때까지 기다리는 대신,
'이 이미지를 처리해줘' 라는 작업을 Message Queue에 넣는다.
그러면 Image Processing Worker가 Queue에 쌓여있는 작업을 하나씩 가져와 실제 이미지 처리를 수행한다.
Web Server와 Image Processing Worker가 직접 연결되어 있지 않기 때문에 두 시스템을 느슨하게 결합(Loosely Coupled)할 수 있게 된다.
비동기로 작업을 처리할 수 있다
Message Queue의 큰 장점 중 하나는 시간이 오래 걸리는 작업을 비동기(Asynchronous)로 처리할 수 있다는 것이다.
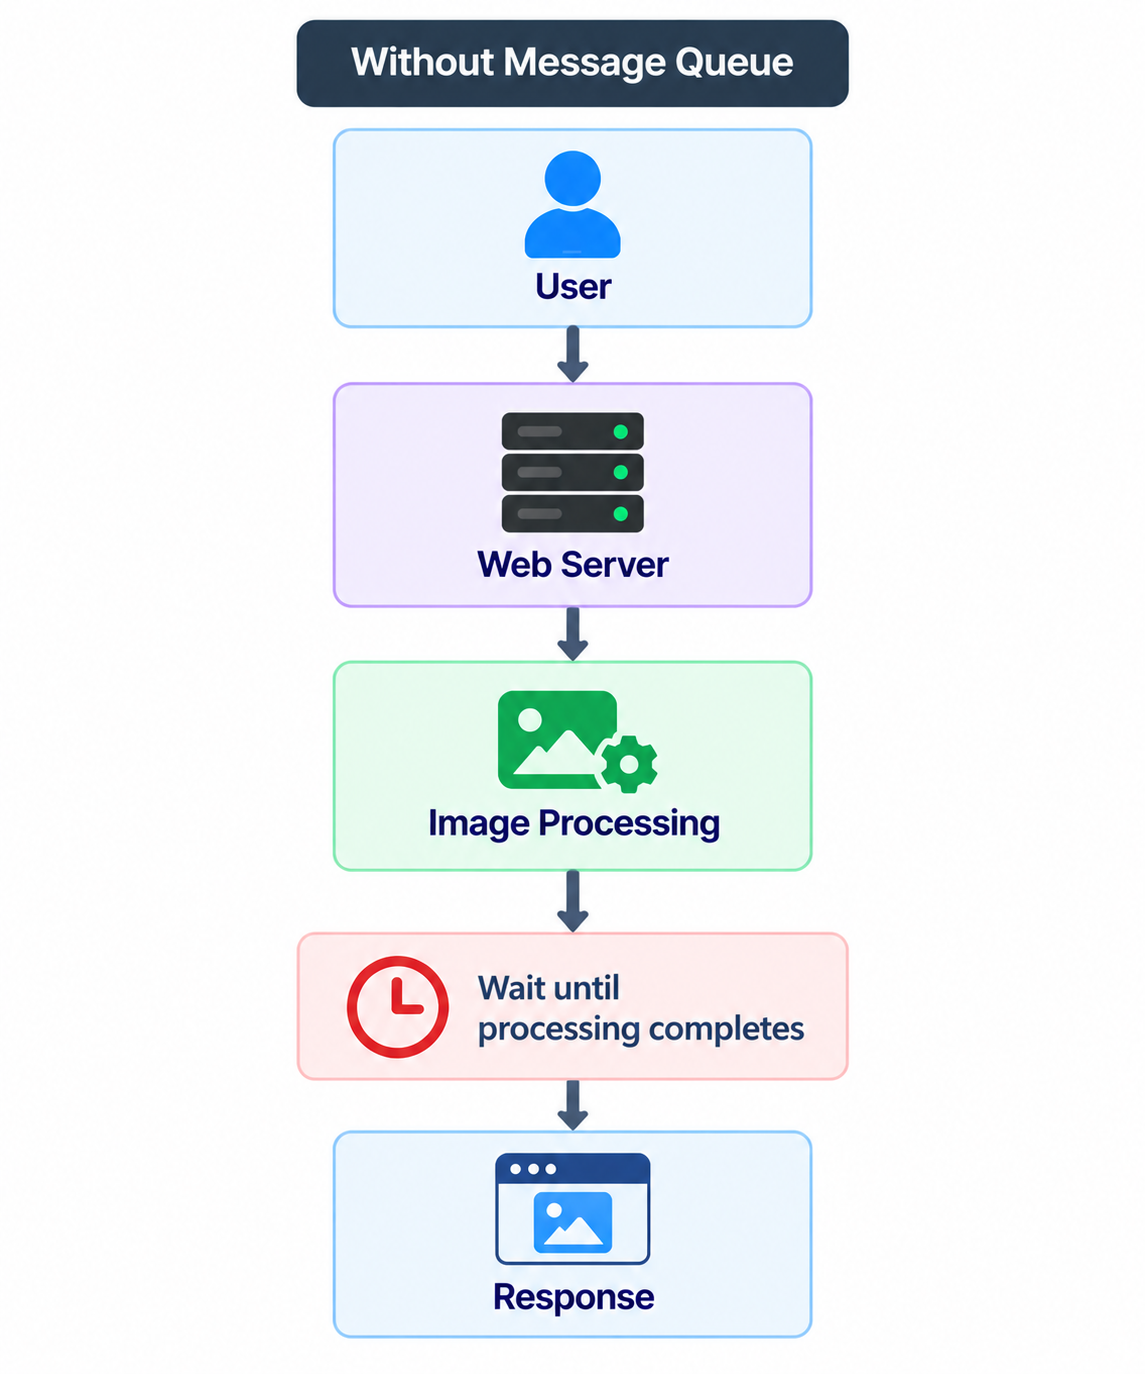
Message Queue를 사용하면,
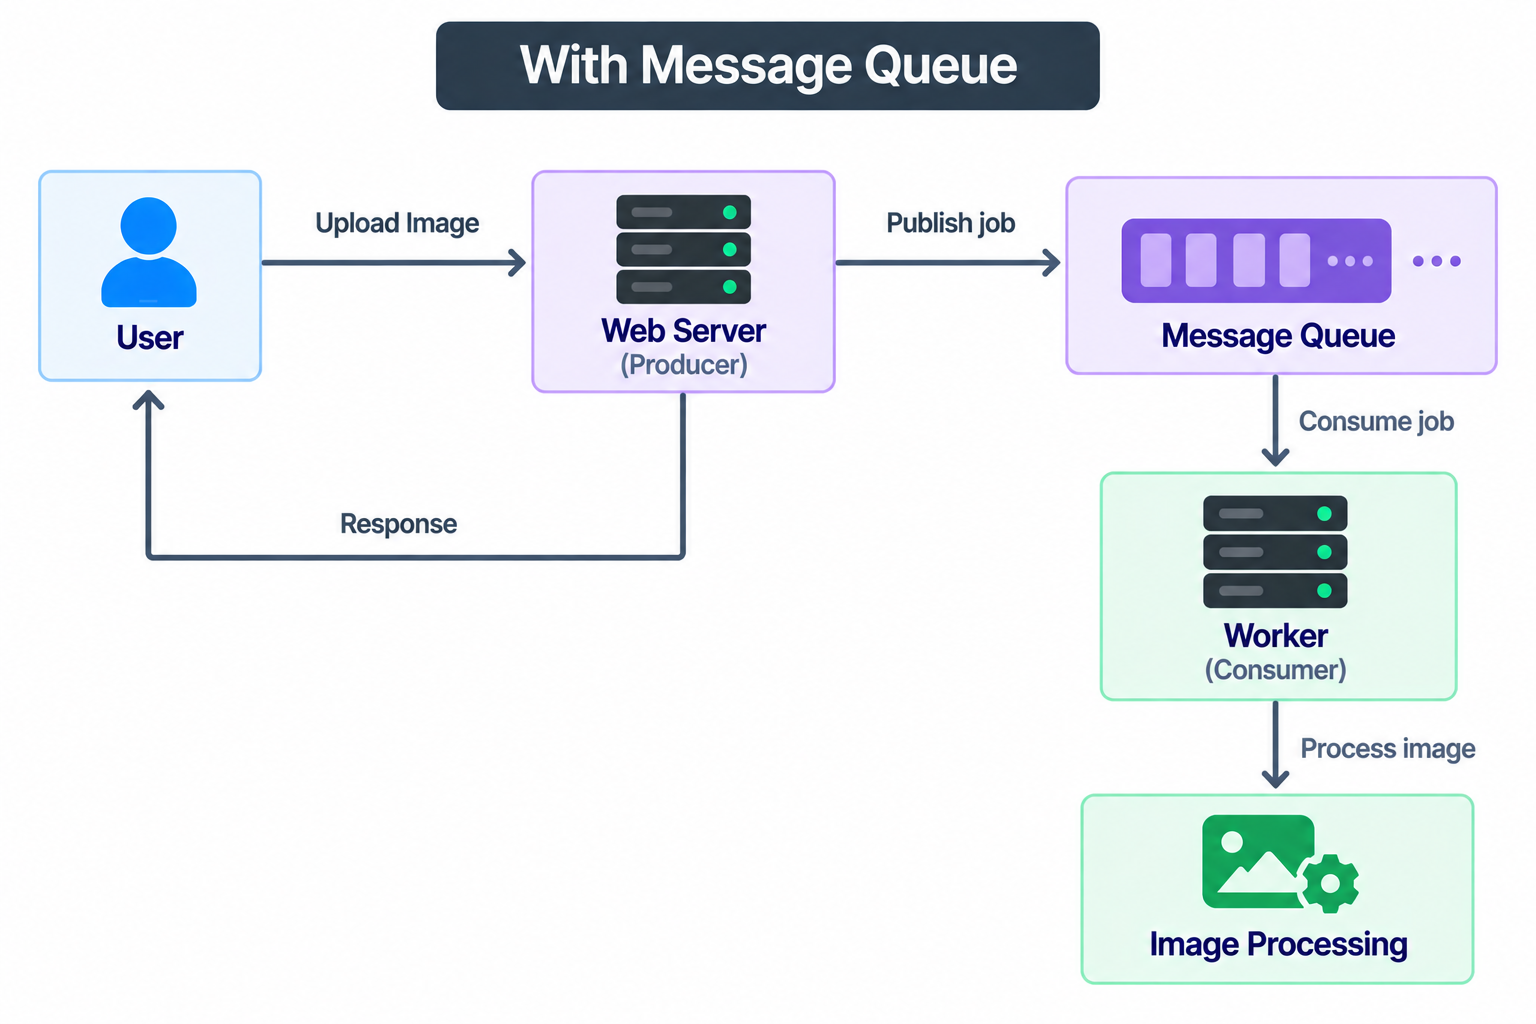
위의 그림 처럼 Web Server는 작업을 Queue에 전달한 뒤 다른 처리를 이어갈 수 있다.
물론 실제 서비스에서는 작업 완료 결과가 필요한 경우 상태를 저장하거나, 이벤트를 발생시키거나, 사용자에게 완료 알림을 보내는 등의 추가적인 처리가 필요하다.
각각 독립적으로 확장할 수 있다
Message Queue를 사용하면 Producer와 Consumer를 독립적으로 확장할 수 있다는 장점도 있다.
예를 들어 평소에는 Worker 두 대만으로 충분하다고 가정해보자.
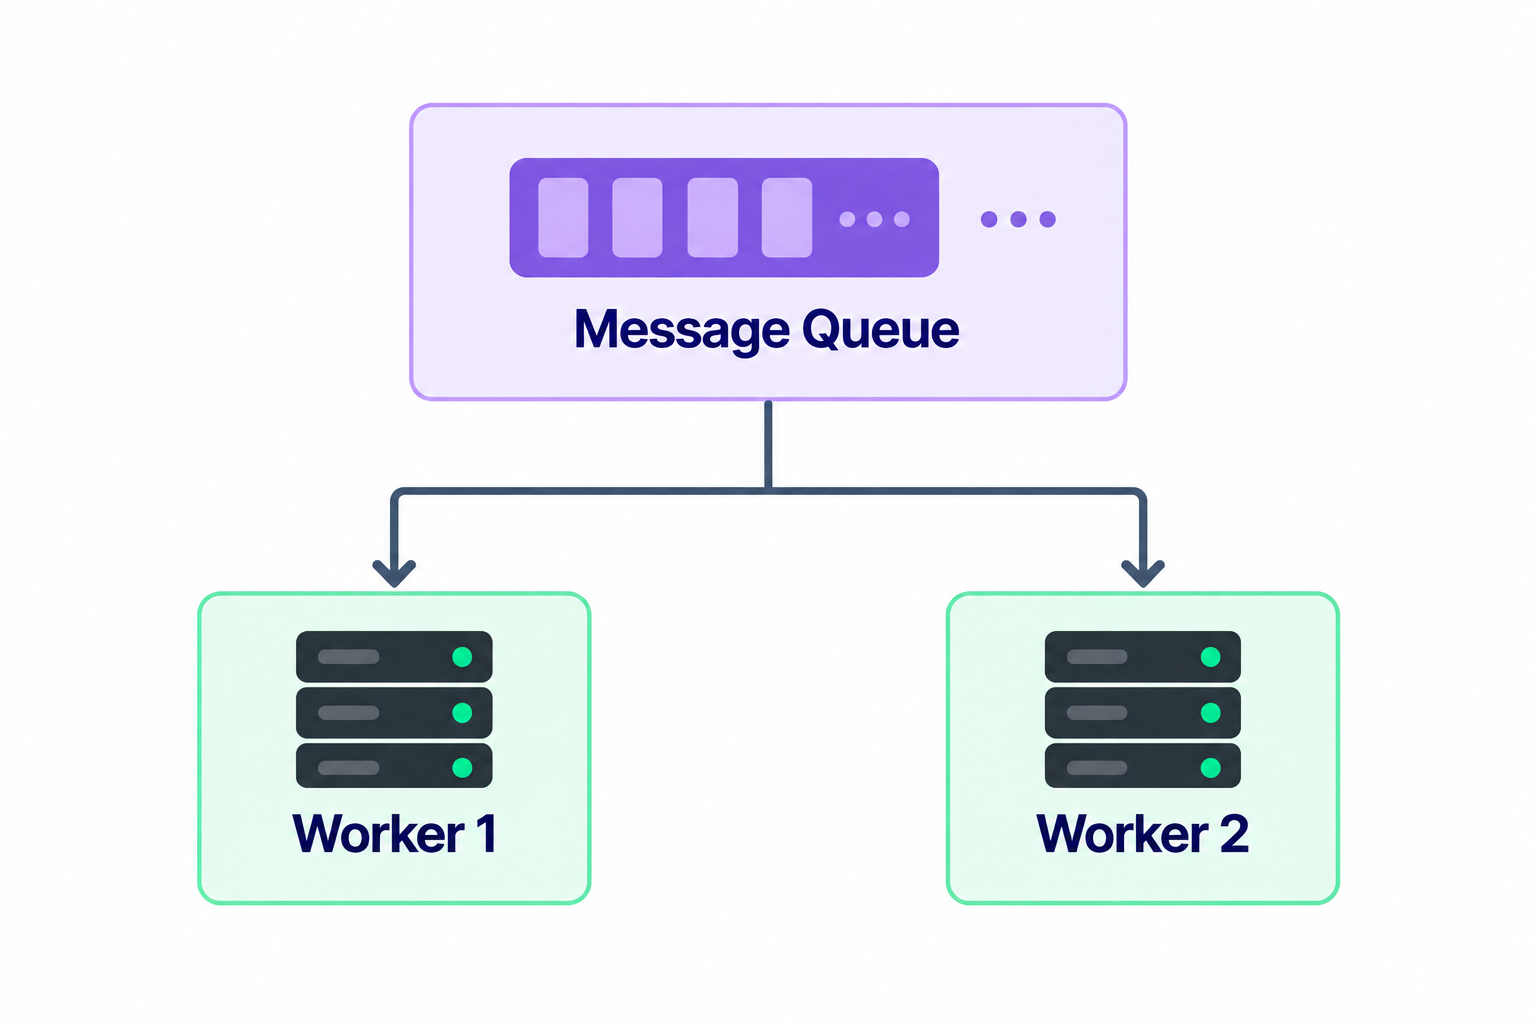
그런데 갑자기 이미지 처리 요청이 증가하여 Queue에 처리하지 못한 Message가 계속 쌓인다면 Worker를 추가할 수 있다.
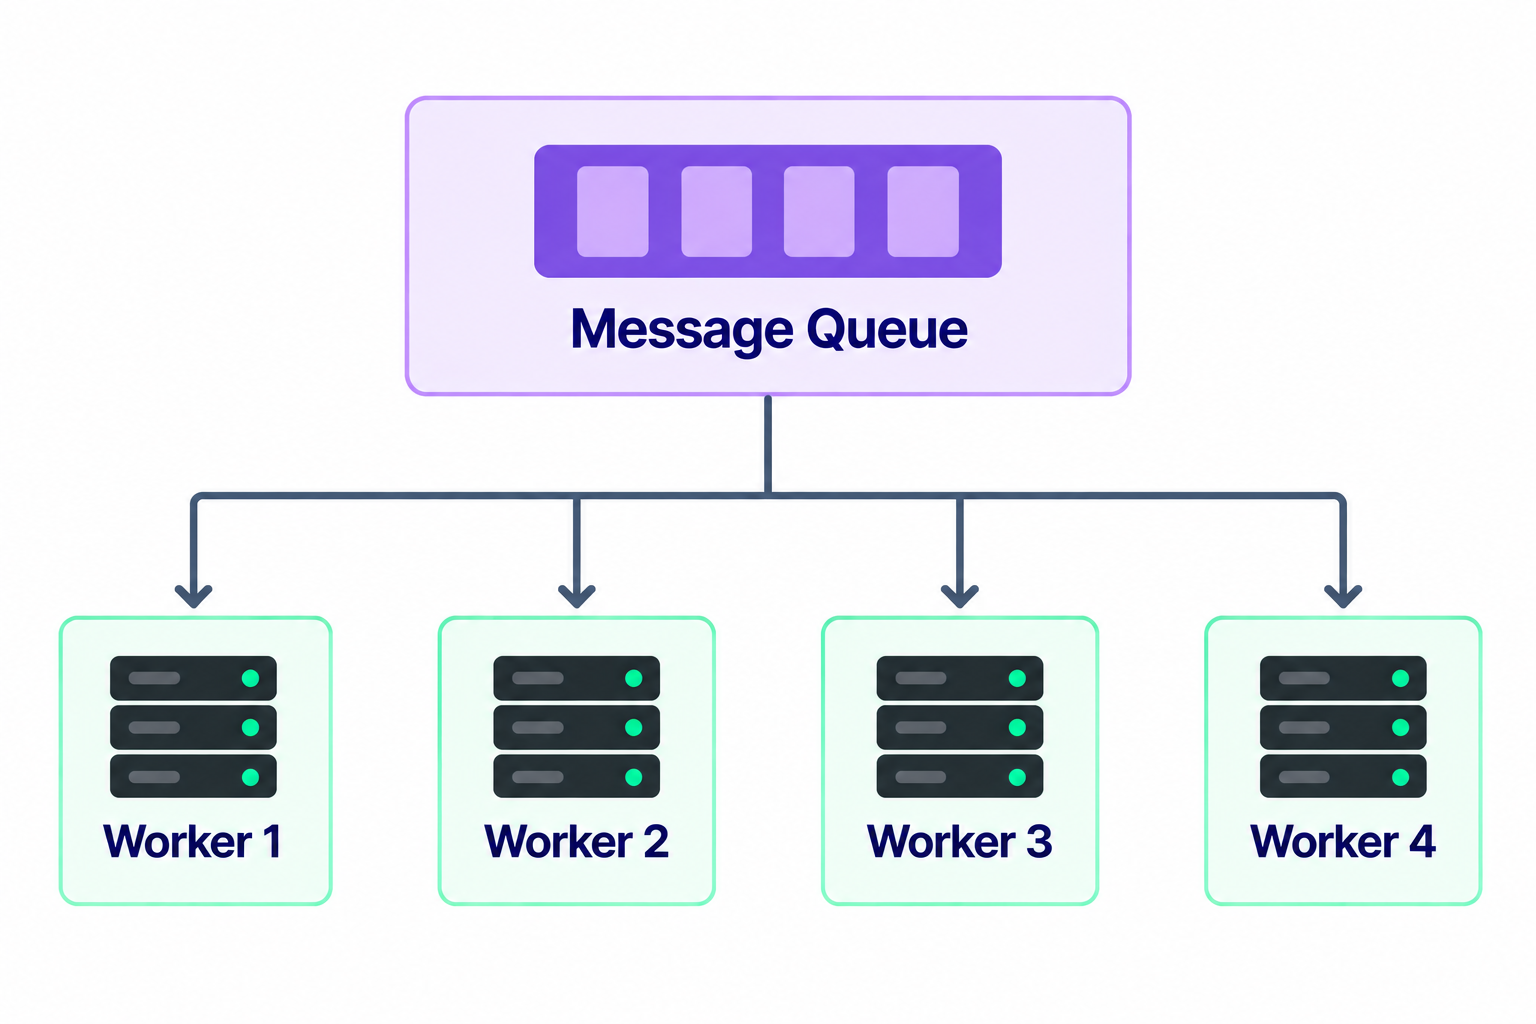
반대로 Queue에 작업이 거의 없다면 Worker의 수를 다시 줄일 수도 있다.
즉 Web Server를 추가하지 않고도 작업을 실제로 처리하는 Consumer만 별도로 Scale Out할 수 있다.
Consumer에 장애가 발생한다면?
Message Queue를 사용하는 이유는 단순히 성능 때문만은 아니다.
Web Server와 Worker가 직접 연결되어 있다면 Worker에 장애가 발생했을 때 작업을 바로 처리할 수 없게 된다.
하지만 Queue를 사이에 두면 Consumer가 일시적으로 작업을 처리하지 못하더라도 Message를 Queue에 보관해두었다가 Consumer가 정상화된 이후 다시 처리할 수 있도록 구성할 수 있다.
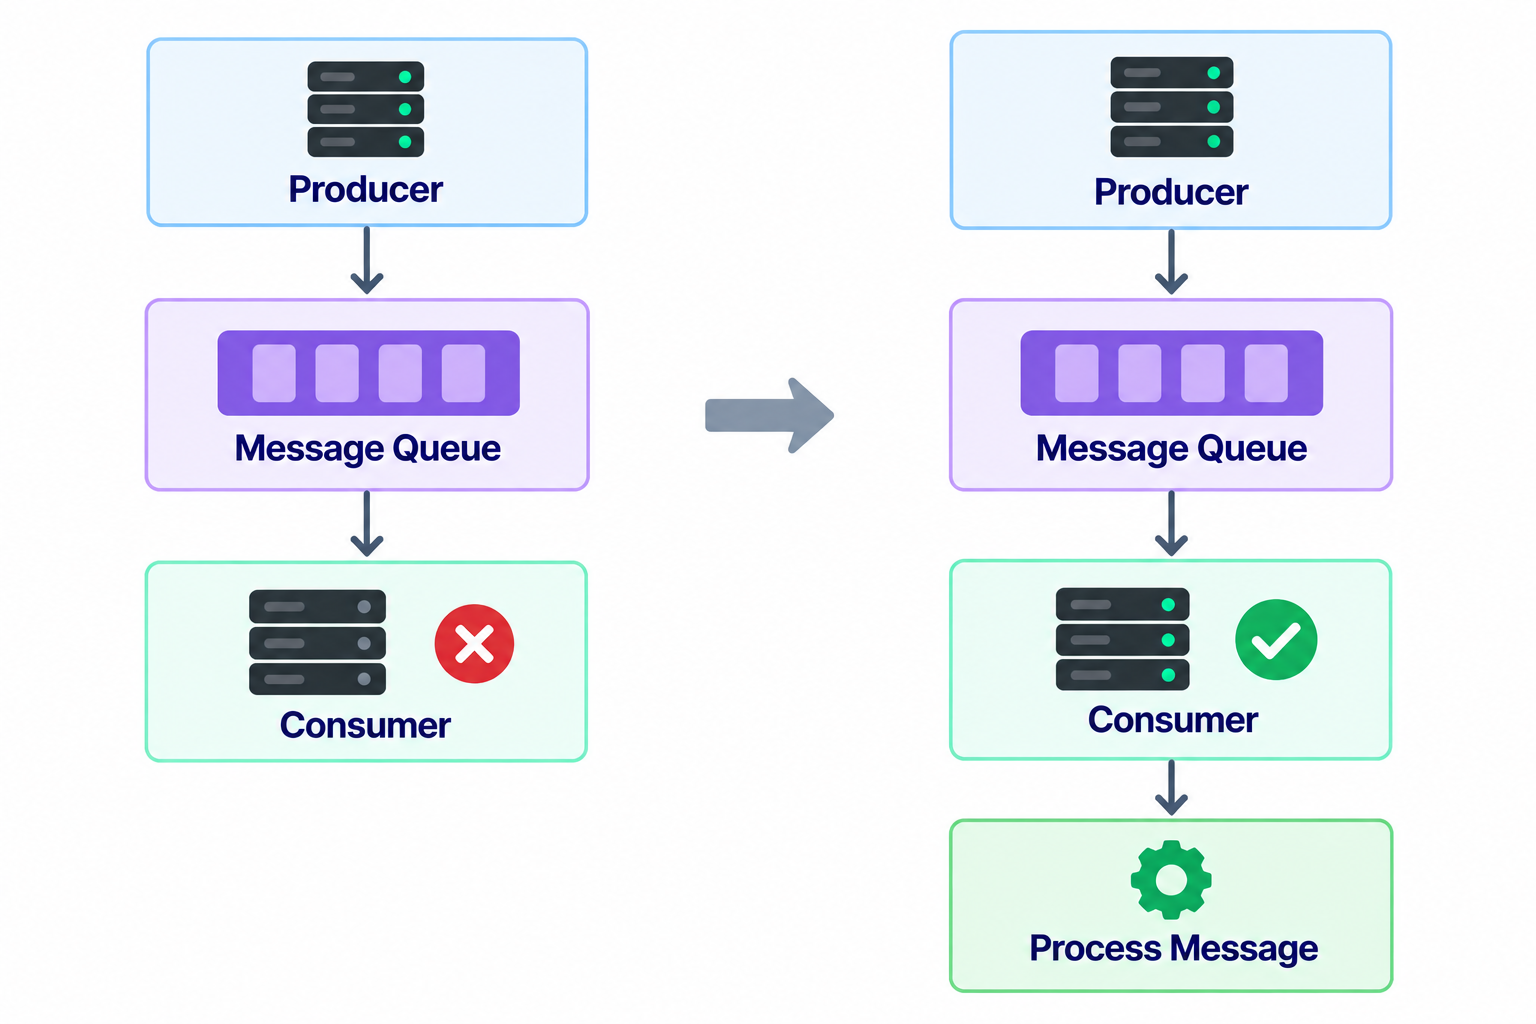
그렇다고 Queue에 넣으면 끝나는 것은 아니다
실제 Message Queue를 사용할 때는 Message 처리 실패에 대한 Retry, 중복 처리, Message 순서, 처리에 계속 실패하는 Message를 별도로 관리하는 Dead Letter Queue(DLQ) 등 여러 부분을 추가로 고려해야 한다.
이번 글에서는 이러한 세부 구현보다는 컴포넌트 사이에 Queue를 두어 서로의 의존성을 낮추고, 비동기 처리와 독립적인 확장을 가능하게 한다는 개념에 집중하고 넘어가려고 한다.
Logging, metrics, automation
지금까지 시스템을 확장하면서 관리해야 할 서버와 구성 요소도 계속해서 늘어났다.
서버가 몇 대뿐인 작은 시스템이라면 문제가 발생했을 때 각각의 서버에 접속해 로그를 확인하는 것도 가능하다.
하지만 Web Server, Database, Cache, Message Queue, Worker 등이 여러 대로 늘어나고 여러 Data Center에 분산되어 있다면 어떨까?
장애가 발생했을 때 어디에서 문제가 발생했는지 파악하는 것 자체가 어려워진다.
시스템의 규모가 커질수록 단순히 서버를 확장하는 것뿐만 아니라 시스템의 상태를 관찰하고 관리하기 위한 Logging, Metrics, Monitoring이 중요해진다.
Logging
각 서버에서 발생하는 로그를 개별적으로 확인하는 대신 중앙화된 곳으로 수집하여 검색하고 분석할 수 있도록 구성한다.
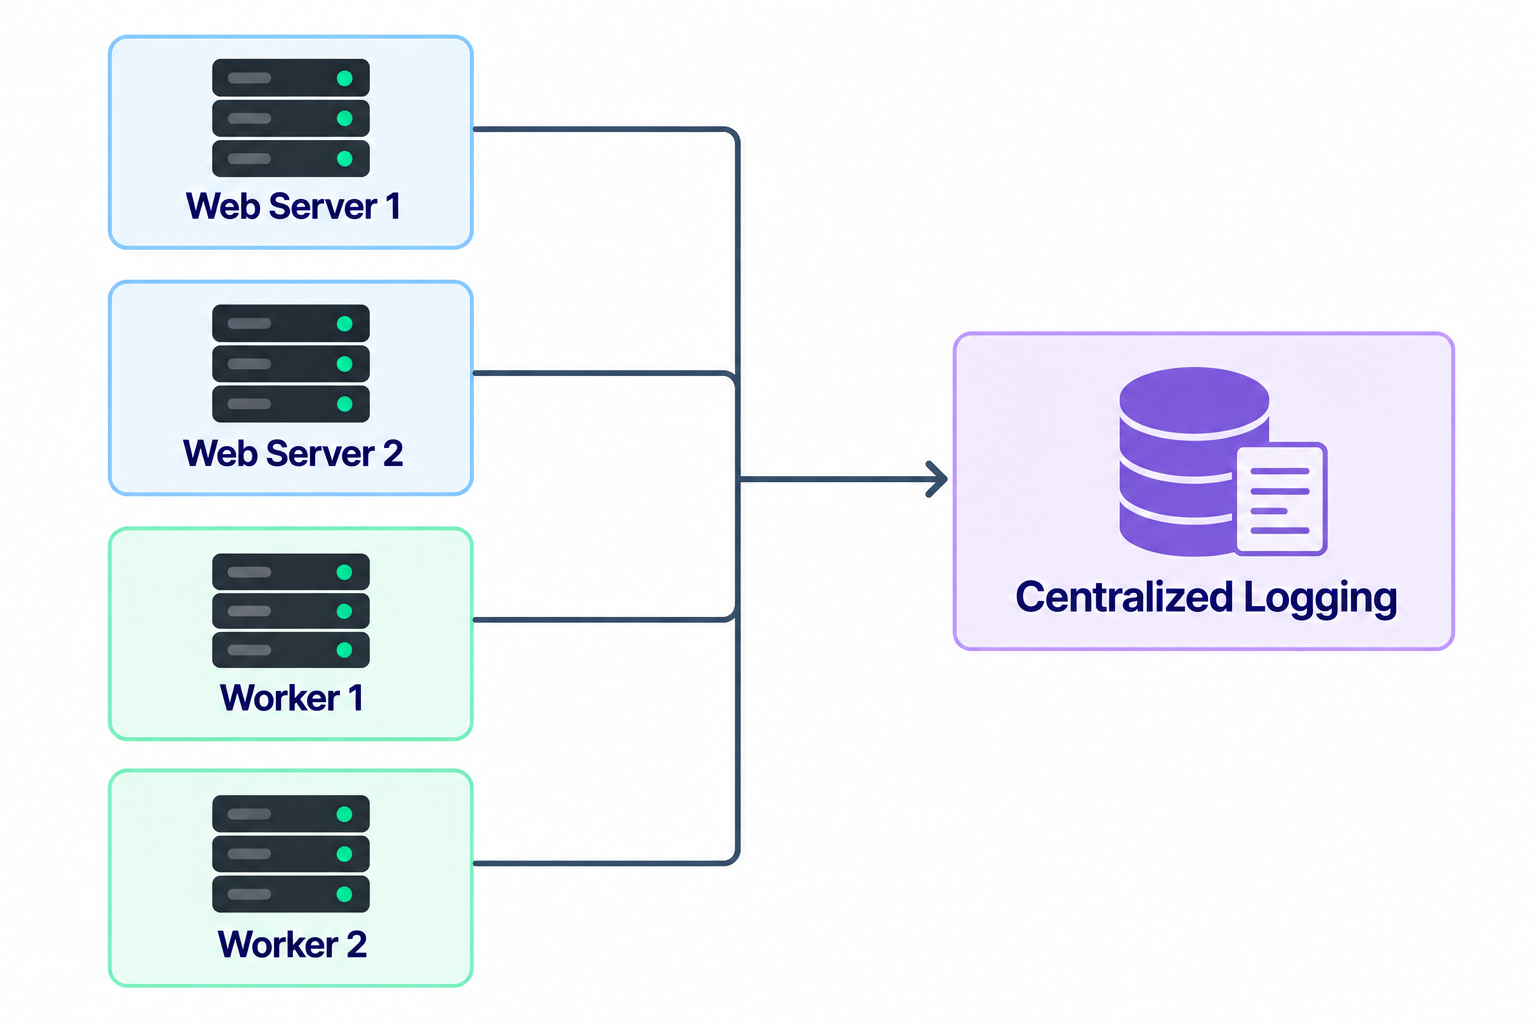
예를 들어 특정 요청에서 오류가 발생했을 때 수십 대의 서버를 하나씩 확인하는 대신 중앙화된 로그에서 해당 요청을 추적할 수 있다.
Metrics
Logging이 “무슨 일이 발생했는가?”를 확인하는 데 가깝다면, Metrics는 시스템의 상태를 숫자로 관찰하는 데 사용한다.
예를 들면
- CPU / Memory / Disk I/O
- Request 수
- Response Time
- Error Rate
- Database Connection 수
- Cache Hit Rate
- Message Queue에 쌓여있는 Message 수
같은 것들이 있다.
이러한 지표를 지속적으로 수집하면 시스템에 문제가 발생하고 있는지 확인할 수 있고, 앞에서 살펴본 Auto Scaling의 기준으로 활용할 수도 있다.
Automation
시스템의 규모가 커질수록 사람이 직접 서버마다 Build, Test, Deploy를 수행하는 것도 현실적으로 어려워진다.
따라서 CI/CD를 통해 Build, Test, Deploy 과정을 자동화하고 여러 서버와 Data Center에 동일한 애플리케이션이 배포될 수 있도록 구성하는 것이 중요하다.
Database Scaling
지금까지 Web Server는 Stateless한 구조와 Auto Scaling을 통해 트래픽에 따라 유연하게 확장할 수 있도록 구성했다.
Message Queue를 추가하면서 시간이 오래 걸리는 작업 역시 Worker를 통해 별도로 처리하고, 필요한 경우 Worker만 독립적으로 Scale Out할 수 있게 되었다.
하지만 서비스가 성장하면서 증가하는 것은 요청의 수뿐만이 아니다.
Database에 저장되는 데이터의 양 역시 계속해서 증가한다.
1편에서는 Database Replication을 통해 하나의 Primary DB 데이터를 여러 Replica DB에 복제하고, 읽기 요청을 분산하는 방법을 알아보았다.
하지만 Replication은 기본적으로 같은 데이터를 여러 Database에 복제하는 방식이다.
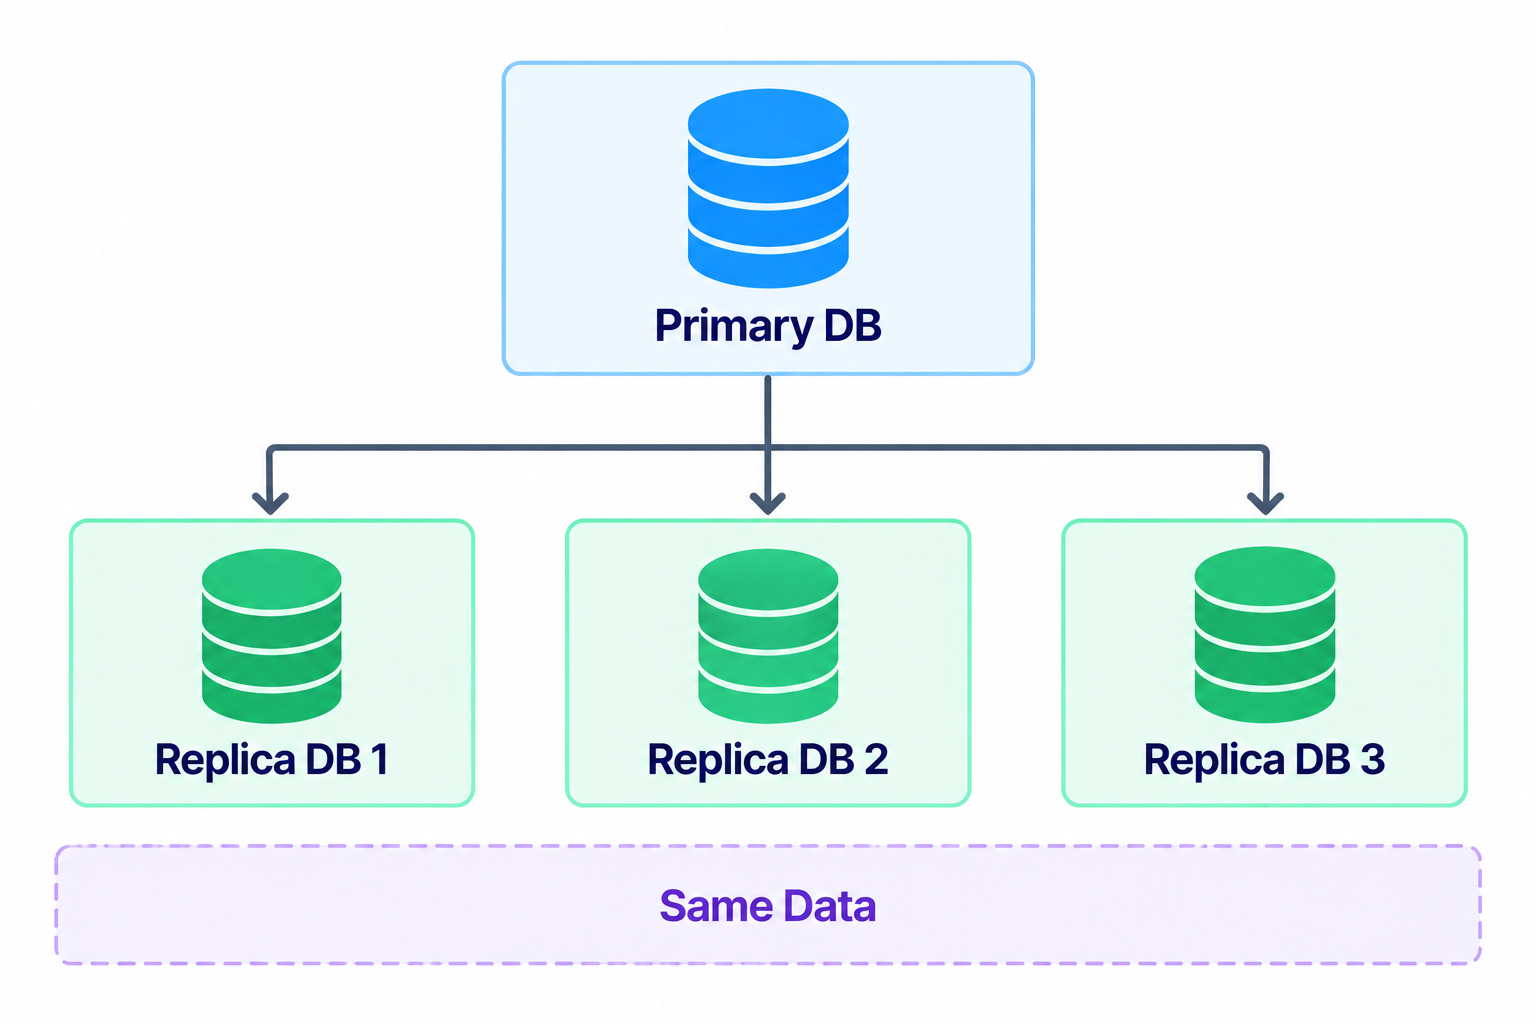
따라서 읽기 부하를 분산하고 가용성을 높이는 데에는 도움이 되지만, 하나의 Database가 저장해야 하는 데이터 자체가 너무 커지는 문제를 해결하는 방법과는 차이가 있다.
그렇다면 Database 자체는 어떻게 확장할 수 있을까?
Vertical Scaling
Web Server와 마찬가지로 Database 역시 가장 간단하게는 Scale Up할 수 있다.
현재 Database Server의 CPU, RAM, Disk 등의 사양을 높여 하나의 Database가 더 많은 데이터를 처리할 수 있도록 만드는 방식이다.
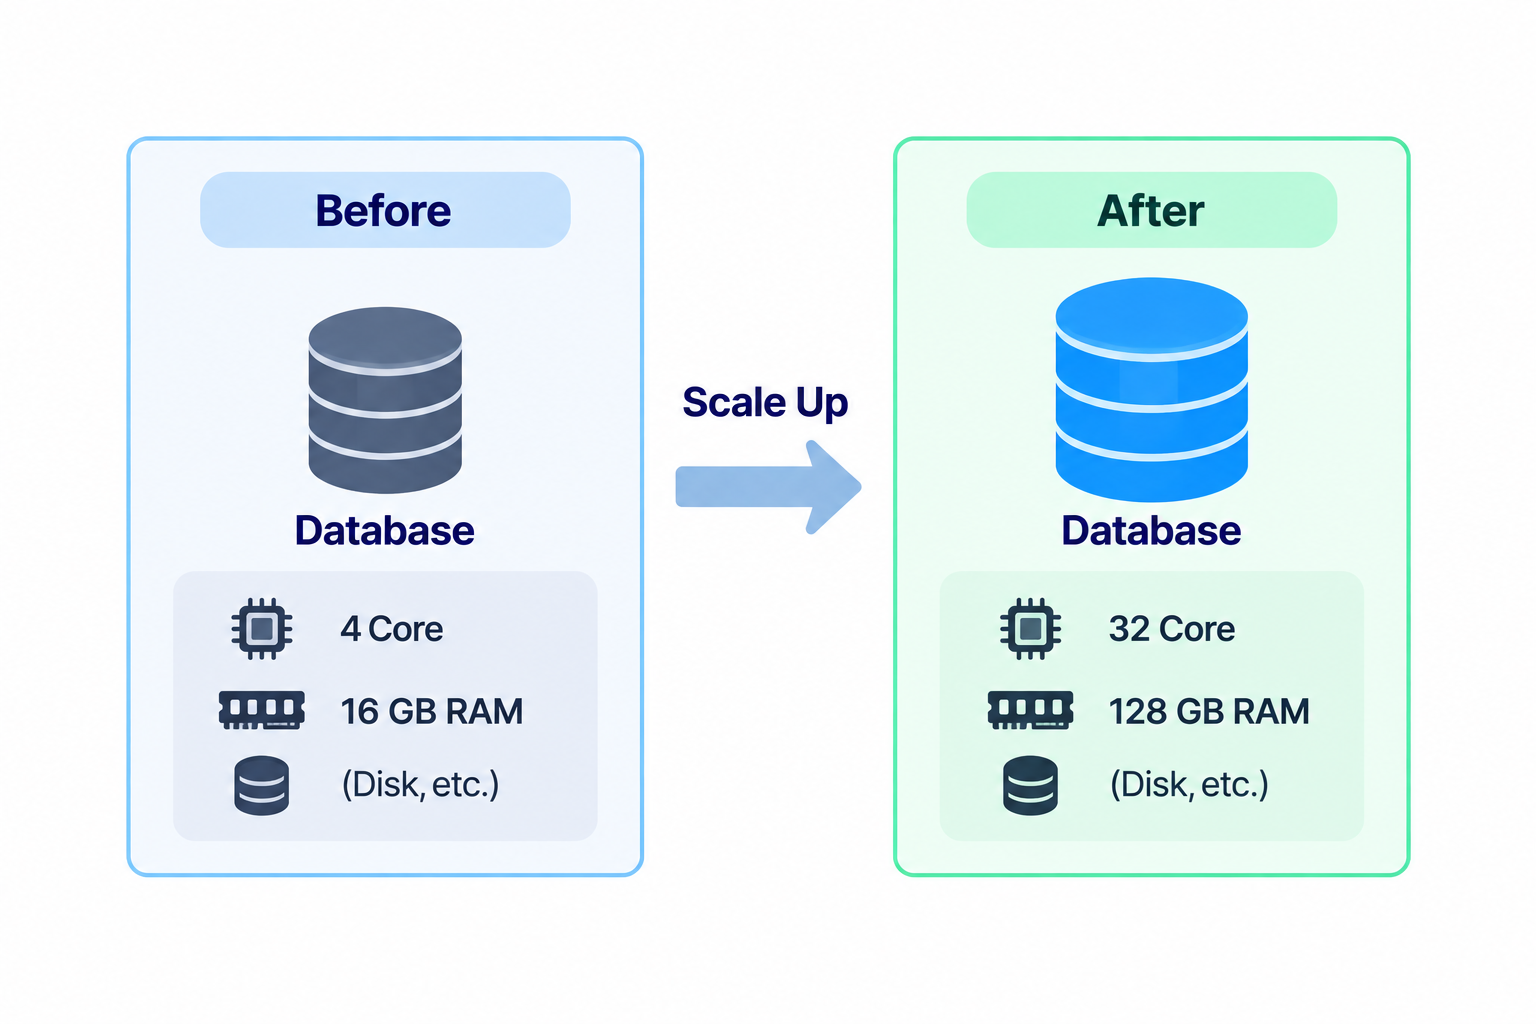
구조를 크게 변경하지 않아도 된다는 장점이 있지만, 이전에 살펴봤던 Scale Up과 마찬가지로 명확한 한계가 존재한다.
CPU와 RAM을 무한정 추가할 수 없고, 서버의 사양이 높아질수록 비용 역시 크게 증가한다.
결국 데이터가 계속해서 증가한다면 하나의 Database Server를 크게 만드는 것만으로는 한계가 생길 수 있다.
이때 Database 자체를 여러 개로 나누는 Horizontal Scaling을 고려할 수 있다.
Sharding
Database에서 Horizontal Scaling을 구현하는 대표적인 방법 중 하나가 Sharding이다.
Replication과 Sharding의 차이를 단순하게 비교하면 다음과 같다.
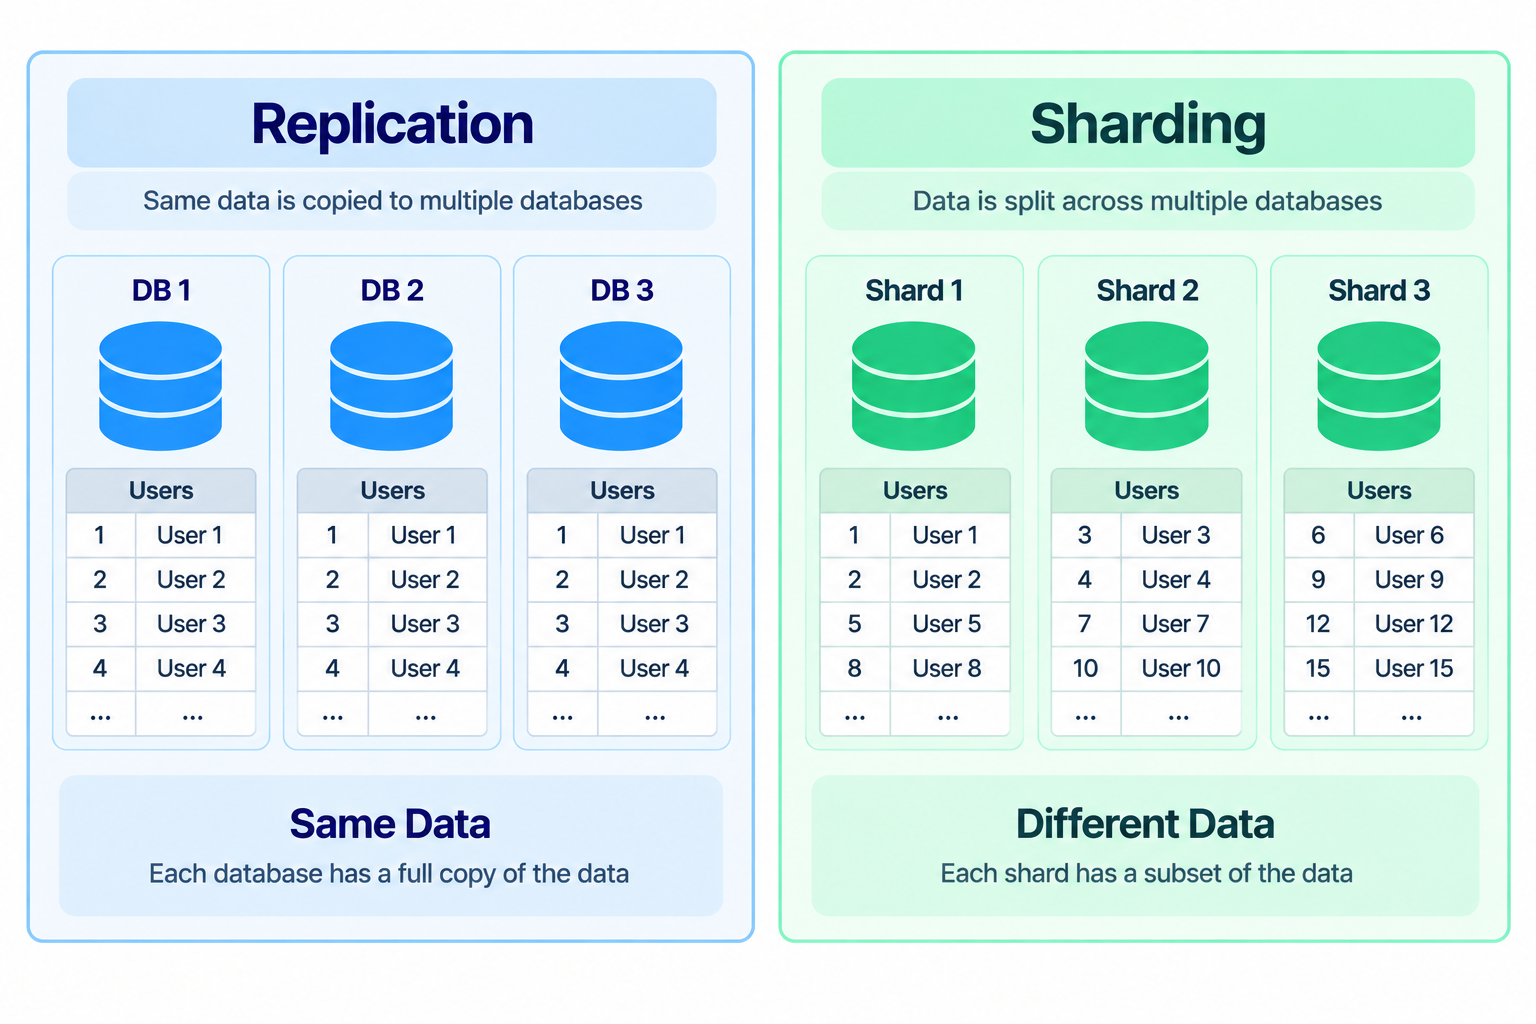
Replication이 같은 데이터를 여러 Database에 복제한다면, Sharding은 전체 데이터를 여러 Database에 나누어 저장한다.
각각의 Database를 Shard라고 부른다.
예를 들어 사용자 데이터가 계속해서 증가한다고 가정해보자.
모든 사용자를 하나의 Database에 저장하는 대신 user_id를 기준으로 4개의 Shard에 나누어 저장할 수 있다.
어떤 Shard에 저장할까?
데이터를 여러 Database로 나눴다면 새로운 문제가 생긴다.
특정 사용자의 데이터가 어느 Database에 저장되어 있는지 어떻게 알 수 있을까?
간단한 예로 다음과 같은 Hash Function을 사용할 수 있다.
user_id % 4
결과가 0이라면 Shard 0, 1이라면 Shard 1에 저장하는 방식이다.
따라서 실제 데이터는 다음과 같이 나누어질 수 있다.
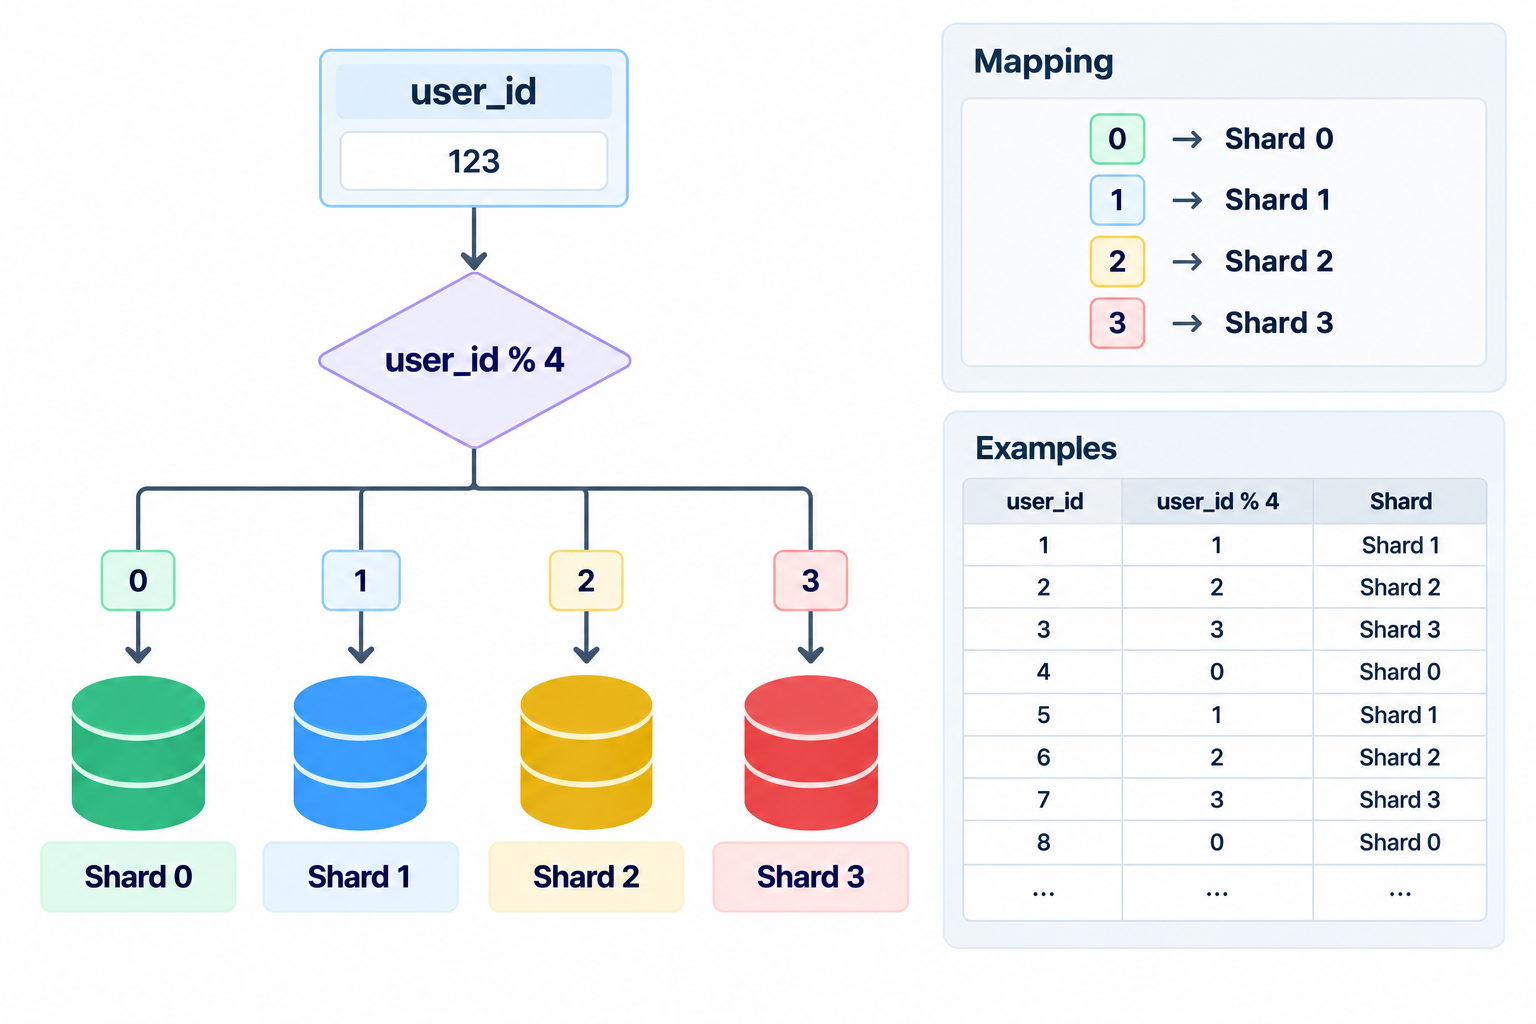
이제 하나의 Database가 모든 사용자 데이터를 저장할 필요가 없어진다.
Sharding Key
여기서 user_id처럼 어떤 Shard에 데이터를 저장할지 결정하는 기준이 되는 값을 Sharding Key 또는 Partition Key라고 한다.
Sharding에서는 이 Key를 어떻게 선택하느냐가 상당히 중요하다.
좋지 않은 Sharding Key를 선택하면 특정 Shard에 데이터나 요청이 몰릴 수 있기 때문이다.
예를 들어 전체 데이터의 대부분이 하나의 Shard에 몰린다면 Database를 여러 개로 나눈 의미가 줄어든다.
따라서 가능한 한 데이터와 요청을 여러 Shard에 고르게 분산할 수 있는 Key를 선택하는 것이 중요하다.
Sharding도 완벽한 해결책은 아니다
Resharding
처음에는 4개의 Shard로 충분했더라도 데이터가 계속해서 증가하면 다시 Shard를 추가해야 할 수 있다.
그런데 앞의 단순한 % 4 방식을 사용하다가 Shard를 하나 추가하여 % 5로 변경하면 많은 데이터의 저장 위치가 달라진다.
따라서 기존 데이터를 새로운 Shard 구성에 맞게 다시 분배하는 Resharding 과정이 필요할 수 있다.
이러한 데이터 이동을 줄이기 위한 방법 중 하나로 Consistent Hashing과 같은 기법을 사용할 수 있다.
이번 글에서는 Consistent Hashing까지 다루지는 않고, Shard의 개수를 변경하는 것이 단순히 Database 하나를 추가하는 것으로 끝나지 않을 수 있다는 정도로 이해하고 넘어가려고 한다.
Hotspot
Shard가 여러 개라고 해서 항상 부하가 고르게 분산되는 것도 아니다.
특정 데이터에 요청이 집중되면 해당 데이터가 저장된 Shard에 트래픽이 몰리는 Hotspot이 발생할 수 있다.
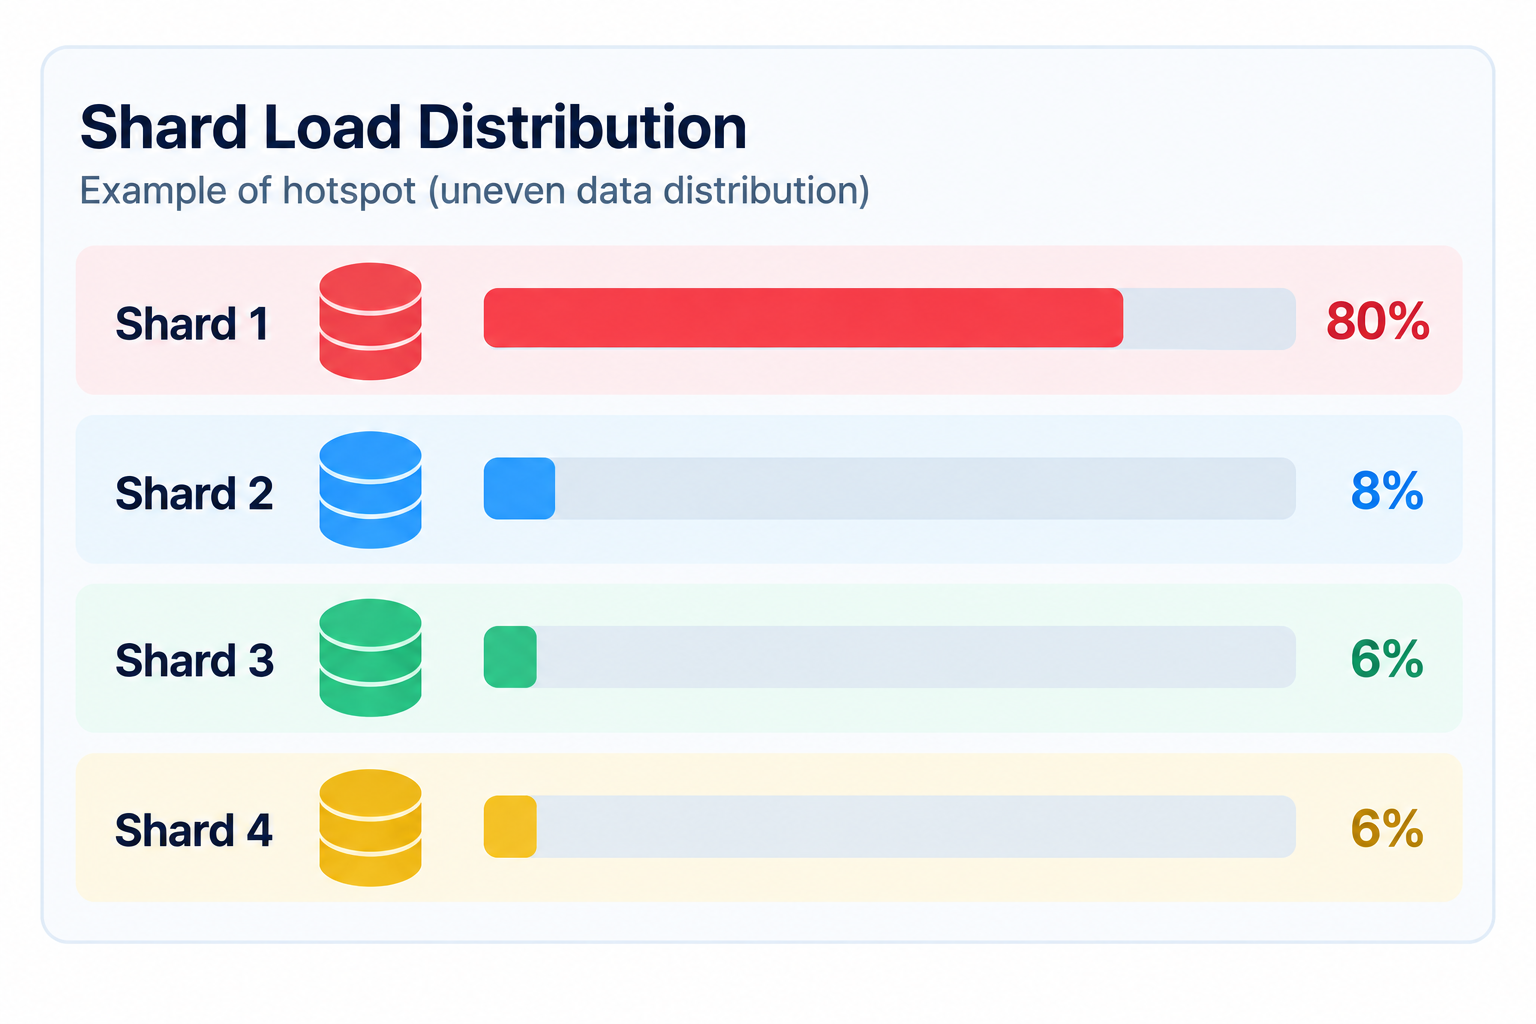
따라서 Sharding Key를 선택할 때는 단순히 저장되는 데이터의 양뿐만 아니라 실제 Access Pattern까지 고려할 필요가 있다.
JOIN
또 다른 문제는 여러 Shard에 나누어진 데이터 간의 연산이다.
하나의 Database 안에서는 비교적 간단했던 JOIN도 필요한 데이터가 서로 다른 Shard에 존재한다면 훨씬 복잡해질 수 있다.
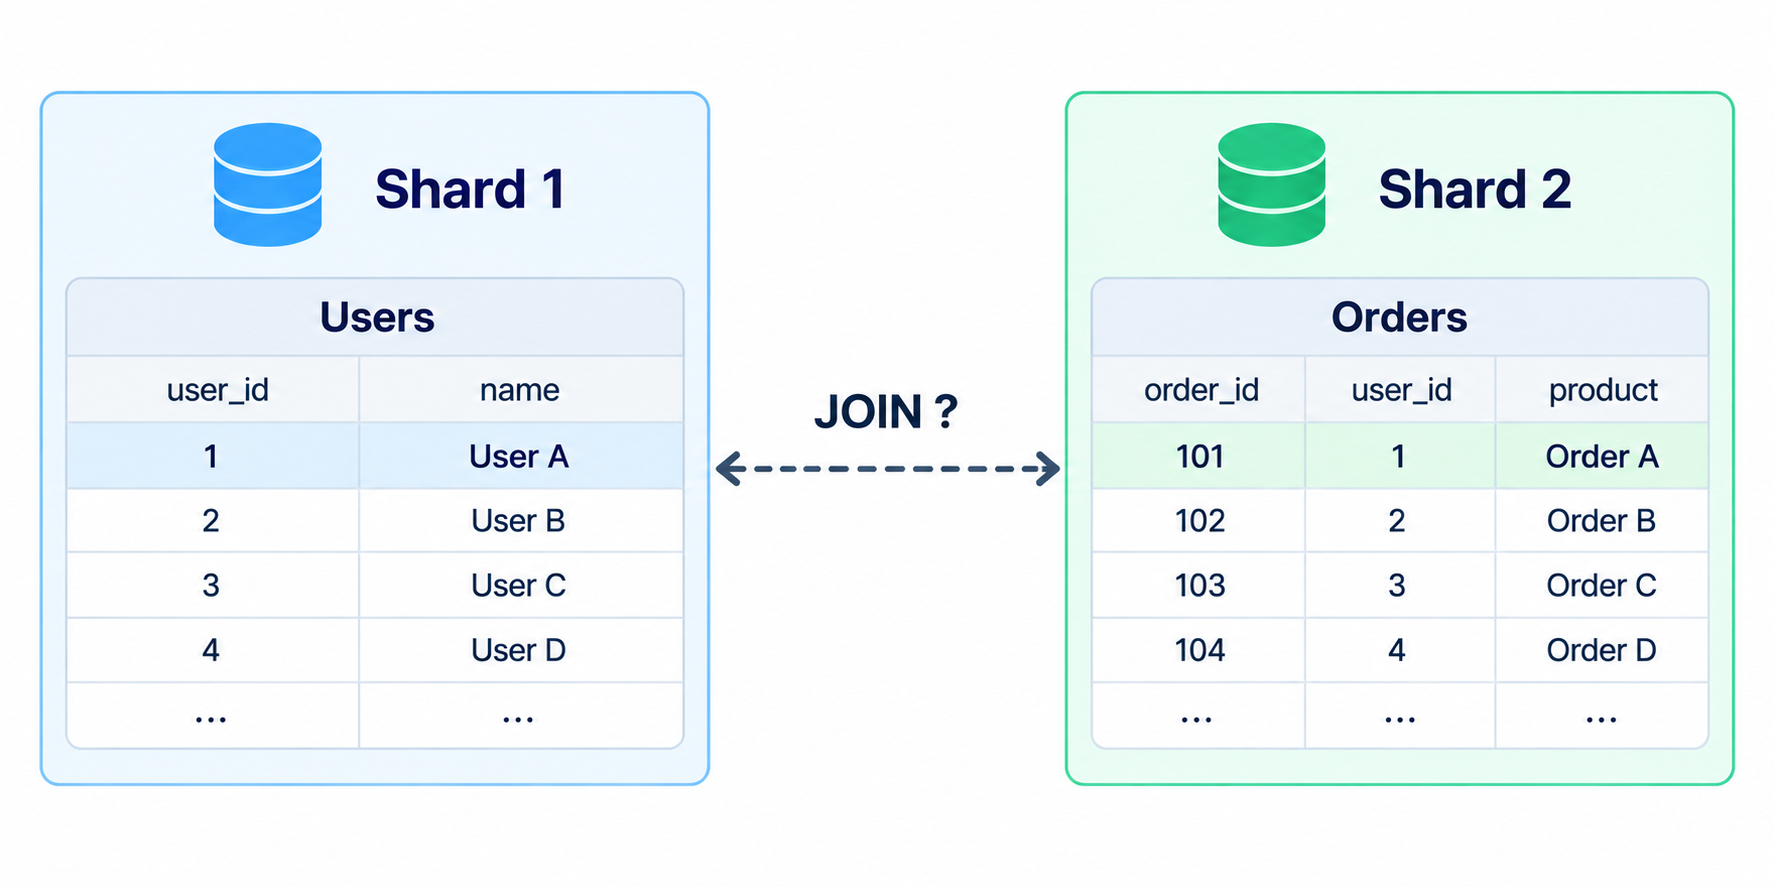
이 때문에 Sharding된 환경에서는 데이터 모델을 변경하거나 일부 데이터를 비정규화하는 등 추가적인 설계가 필요할 수 있다.
결국 Sharding은 Database를 확장할 수 있는 강력한 방법이지만, 그만큼 시스템의 복잡도 역시 크게 증가시키는 방법이라고 볼 수 있다.
마무리

처음에는 하나의 서버에서 시작했지만 사용자가 증가하면서 시스템의 구조도 계속해서 변화했다.
서버의 처리량이 부족해지면서 Scale Out과 Load Balancer를 적용했고, Database Replication과 Cache를 통해 Database의 부하를 줄였다.
이후 Stateless Web Tier와 Auto Scaling을 통해 Web Server를 유연하게 확장할 수 있도록 만들었고, Multi Data Center를 통해 지역 단위의 장애까지 대응할 수 있도록 구성했다.
Message Queue를 추가하면서 각각의 컴포넌트를 느슨하게 결합하고 독립적으로 확장할 수 있게 되었으며, 데이터 자체가 커지는 문제에 대응하기 위해 Database Sharding까지 살펴보았다.
이렇게 정리하고 보니 대규모 트래픽을 처리하는 시스템을 만든다는 것은 단순히 성능이 좋은 서버를 사용하는 문제가 아니었다.
현재 시스템에서 병목이나 단일 장애 지점이 어디에 있는지 찾고, 필요한 부분을 하나씩 분리하고 확장해나가는 과정에 가까웠다.
물론 실제 서비스에서는 모든 시스템에 지금까지 살펴본 구조가 필요한 것은 아니다. 시스템의 규모와 트래픽, 데이터의 특성, 비용 등을 고려하여 필요한 구조를 선택하는 것이 더 중요하다고 생각한다.
이번 글에서는 전체적인 확장 과정을 살펴보는 데 집중했기 때문에 각각의 기술을 깊게 다루지는 않았다. 이후에는 Cache Strategy, Database Replication, Sharding, Message Queue와 같이 이번 글에서 간단하게 넘어간 주제들도 깊게 살펴보면 좋을것 같다.
'Infra' 카테고리의 다른 글
| 사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #1 (0) | 2026.09.28 |
|---|---|
| Elasticsearch (0) | 2026.03.18 |
| Kafka란? (feat.성능과 고가용성) (0) | 2025.03.26 |
| 클러스터와 노드 개념 (0) | 2025.03.24 |
| Nginx 알아보기 (0) | 2025.03.04 |