Consistent Hashing 알아보기
사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #2사용자 0명에서 수백만 명까지, 서비스는 어떻게 확장될까? #1최근에 꽤 규모가 있는 프로젝트를 하면서 아키텍처 설계부터 인프라
constant1601.tistory.com
이전 글에서는 서버가 추가되거나 제거되는 상황에서 데이터의 재배치를 최소화하기 위한 Consistent Hashing에 대해 알아보았다.
그전에는 Web Server를 Scale Out하고, Cache와 Message Queue를 적용하면서 더 많은 트래픽을 처리하는 방법도 살펴보았다.
그런데 서버를 늘리고 요청을 분산한다고 해서 모든 요청을 무한정 처리할 수 있는 것은 아니다.
특정 사용자가 짧은 시간 동안 수천 번의 API를 호출하거나, 외부 API를 호출하는 요청이 갑자기 몰린다면 어떻게 될까?
다른 사용자의 요청까지 느려지거나, 예상하지 못한 비용이 발생할 수도 있다.
그렇다면 들어오는 요청을 모두 처리하는 대신, 일정한 기준을 넘는 요청은 제한할 수 없을까?
이를 위해 사용하는 것이 Rate Limiter이다. 이번 글에서는 Rate Limiter가 어떤 기준으로 요청을 제한하고, 여러 서버가 있는 환경에서는 무엇을 고려해야 하는지 알아보려고 한다.
Rate Limiter
Rate Limiting은 일정한 시간 동안 허용할 요청의 수나 속도를 제한하는 것이다. 이 제한을 실제로 검사하고 적용하는 구성 요소를 Rate Limiter라고 한다.
예를 들어 다음과 같은 정책을 생각해볼 수 있다.
사용자 한 명당 1분에 100번의 API 요청을 허용한다.
요청이 들어오면 해당 사용자가 제한을 넘었는지 확인한다. 허용 범위라면 Server로 전달하고, 제한을 초과했다면 요청을 거부한다.
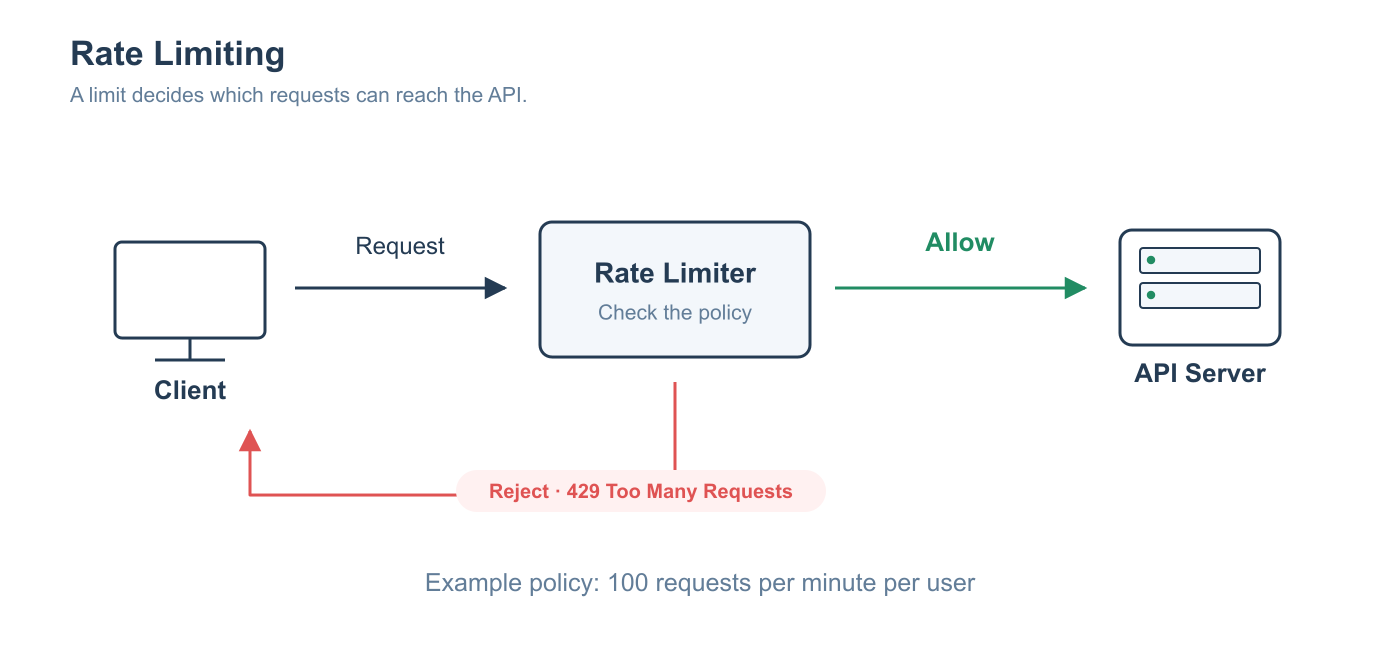
HTTP API에서는 제한을 초과한 요청에 429 Too Many Requests를 반환할 수 있다.
HTTP/1.1 429 Too Many Requests
Retry-After: 10
여기서 Retry-After는 다시 요청하기 전 얼마나 기다려야 하는지 알려주는 선택적인 헤더이다. 위 예시의 10은 응답을 받은 뒤 10초를 기다리라는 뜻이며, HTTP 날짜로 표현할 수도 있다. 기다린 뒤 요청이 반드시 성공한다는 의미는 아니다.
무엇을 기준으로 제한할까?
같은 1분에 100번이라는 정책이라도 무엇을 기준으로 세는지에 따라 결과가 달라진다.
- 사용자 ID — 사용자별로 요청 수를 제한한다.
- API Key — API를 사용하는 고객이나 애플리케이션별로 제한한다.
- IP Address — 로그인하지 않은 요청에도 적용할 수 있다.
- API Endpoint — 비용이 큰 검색이나 파일 변환 API 등에 별도의 제한을 둔다.
다만 IP 하나를 사용자 한 명과 같다고 볼 수는 없다. 회사나 학교처럼 여러 사용자가 하나의 공인 IP를 공유하는 경우도 있기 때문이다.
따라서 서비스에 맞게 사용자별 제한과 API별 제한 등을 함께 적용할 수 있다.
Rate Limiter는 어디에 둘까?
API Gateway나 Reverse Proxy에서 요청을 먼저 검사할 수도 있고, 애플리케이션의 Middleware에서 사용자 정보와 비즈니스 규칙을 이용해 검사할 수도 있다.
Client에서도 불필요한 요청을 줄일 수는 있지만, Client의 제한은 우회할 수 있으므로 보호하려는 시스템의 서버 측에서도 제한을 적용해야 한다.
그런데 여기서 한 가지 문제가 있다.
앞에서 말한 1분에 100번은 정확히 어느 1분을 의미할까?
Fixed Window Counter
가장 먼저 생각할 수 있는 방법은 시간을 고정된 구간으로 나누고, 각 구간의 요청 수를 세는 것이다.
예를 들어 1분 단위로 구간을 나눈다고 가정해보자.
12:00:00 이상 ~ 12:01:00 미만 → 하나의 Window
12:01:00 이상 ~ 12:02:00 미만 → 다음 Window
각 Window에서 요청이 들어올 때마다 Counter를 증가시킨다. 100번까지 허용하고, 이후 요청은 다음 Window가 시작될 때까지 거부한다.
이처럼 고정된 시간 구간과 Counter를 사용하는 방식을 Fixed Window Counter라고 한다.
구현이 단순하고 요청 하나하나의 시간을 저장할 필요도 없다. 사용자별로 현재 Window와 Counter 정도만 관리하면 된다.
Window의 경계에 요청이 몰린다면?
하지만 12시 0분 59초에 요청 100개가 들어오고, 바로 다음인 12시 1분 0초에 다시 100개가 들어온다고 가정해보자.
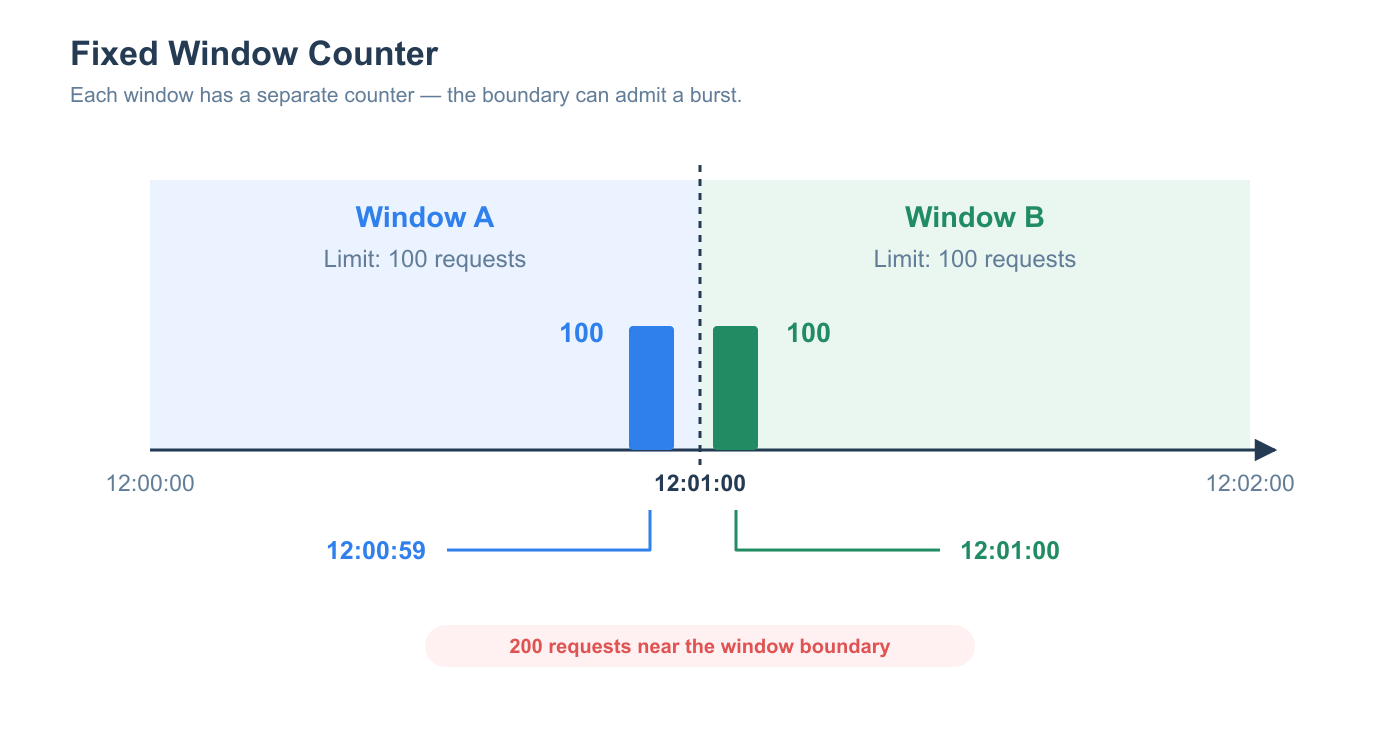
첫 번째 Window에서도 100개, 두 번째 Window에서도 100개이므로 각각의 제한은 지켰다.
하지만 Server 입장에서는 경계 전후의 아주 짧은 시간 동안 200개의 요청을 전달받게 된다.
즉, 고정된 각 1분 구간에서 100개를 허용하는 것과 어느 시점에서 보더라도 최근 1분 동안 100개만 허용하는 것은 서로 다르다.
그렇다면 구간을 고정하지 않고 현재 시점을 기준으로 최근 요청을 확인할 수는 없을까?
Sliding Window
Sliding Window Log
Sliding Window Log는 허용한 요청의 Timestamp를 저장하는 방법이다.
현재 시각이 12시 1분 15초라면, 최근 1분에 해당하는 요청만 남기고 그보다 오래된 기록은 제거한다.
현재 시각: 12:01:15
검사 범위: 최근 60초
1. 범위를 벗어난 Timestamp를 제거한다.
2. 남아 있는 요청 수가 100개 미만인지 확인한다.
3. 여유가 있으면 현재 Timestamp를 추가하고 허용한다.
4. 이미 100개라면 거부한다.
구간이 현재 시각과 함께 이동하기 때문에 Fixed Window의 경계에서 제한량이 두 배로 몰리는 문제를 줄일 수 있다.
다만 최근 1분의 요청 수를 정확히 제한하는 것이지, 요청을 일정한 간격으로 보내는 것은 아니다. 최근 요청이 없다면 100개가 한꺼번에 들어와도 허용할 수 있다.
또한 허용한 요청마다 Timestamp를 저장해야 하므로, 관리하는 사용자와 요청이 많아질수록 메모리 사용량과 정리 비용이 커진다.
Sliding Window Counter
그렇다면 모든 Timestamp를 저장하지 않고 비슷한 효과를 낼 수는 없을까?
Sliding Window Counter는 이전 Window와 현재 Window의 요청 수를 이용해 최근 구간의 요청 수를 추정하는 방법이다.
예를 들어 다음과 같은 상태라고 가정해보자.
이전 1분의 요청 수: 80개
현재 1분의 요청 수: 20개
현재 Window에서 경과한 시간: 15초
현재 시점에서 최근 60초를 보면 이전 Window의 마지막 45초와 현재 Window의 15초가 포함된다.
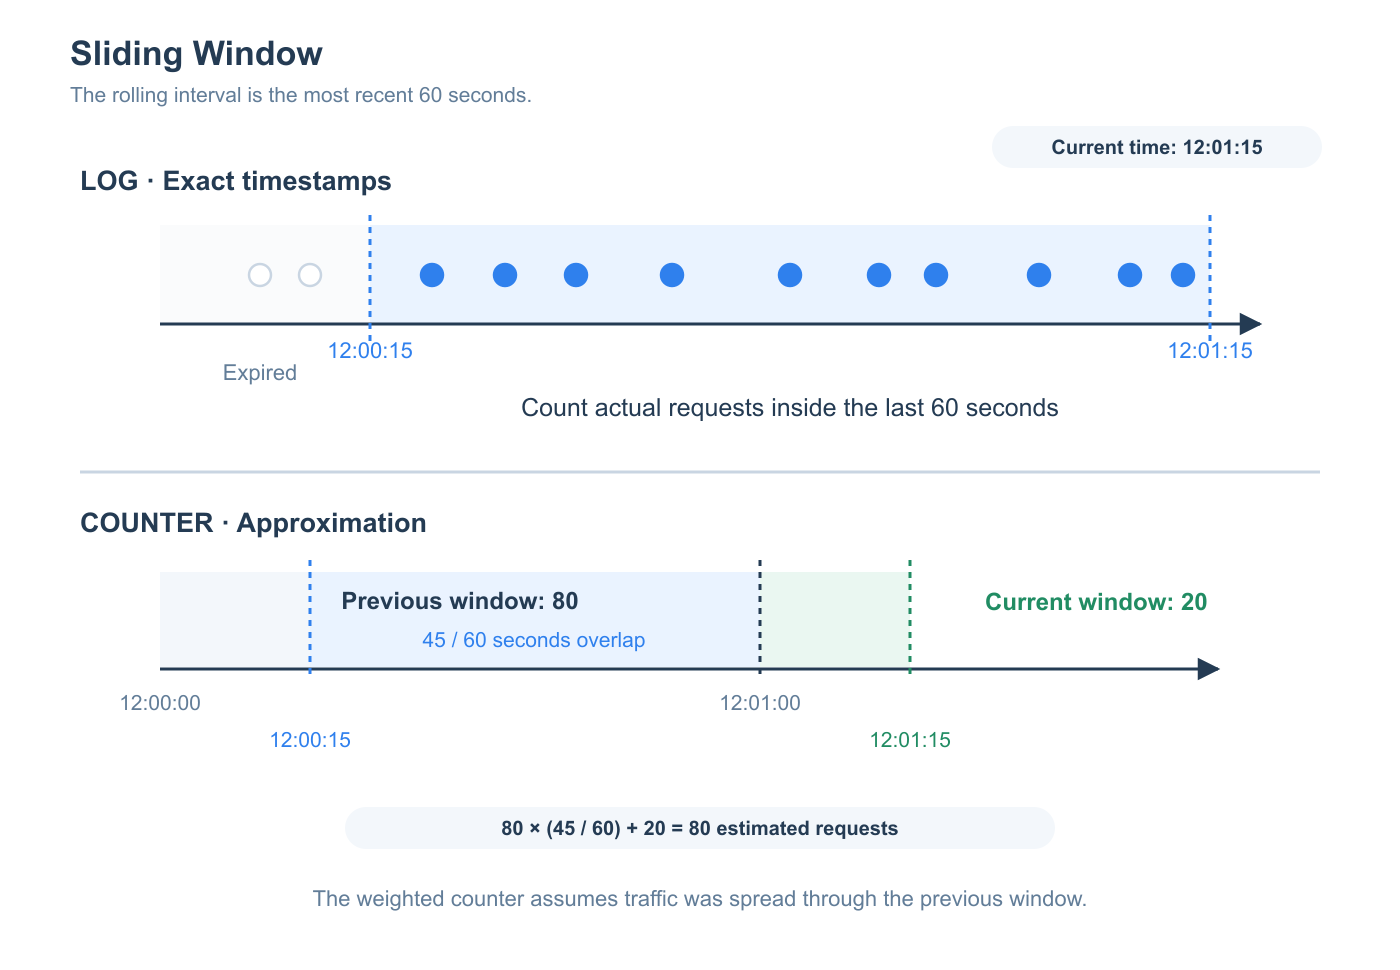
이전 Window에서 요청이 고르게 들어왔다고 가정하면, 이전 요청 80개의 75%가 최근 60초에 포함된다고 볼 수 있다.
추정 요청 수
= 현재 Window의 요청 수 + 이전 Window의 요청 수 × 겹치는 비율
= 20 + 80 × (45 / 60)
= 80
따라서 위 상태에서 새 요청 하나가 들어오면 추정값 81을 기준으로 제한량 100과 비교할 수 있다.
요청마다 Timestamp를 저장하는 방법보다 메모리를 적게 사용하지만, 이전 요청들이 실제로 어느 시점에 몰렸는지는 알 수 없다.
결국 정확한 최근 요청 수와 메모리 사용량 사이에서 절충한 방식이라고 볼 수 있다.
Token Bucket
지금까지는 일정 시간 동안 들어온 요청을 세는 방법을 살펴보았다.
그런데 서비스에 따라서는 잠깐의 요청 집중은 허용하면서, 지속적으로 과도한 요청을 보내는 것은 제한하고 싶을 수 있다.
이를 위해 사용할 수 있는 방법 중 하나가 Token Bucket이다.
이름 그대로 Token을 담아두는 Bucket이 있다고 생각해보자.
Bucket의 최대 용량: Token 5개
Token 보충 속도: 초당 2개
요청 하나에 필요한 Token: 1개
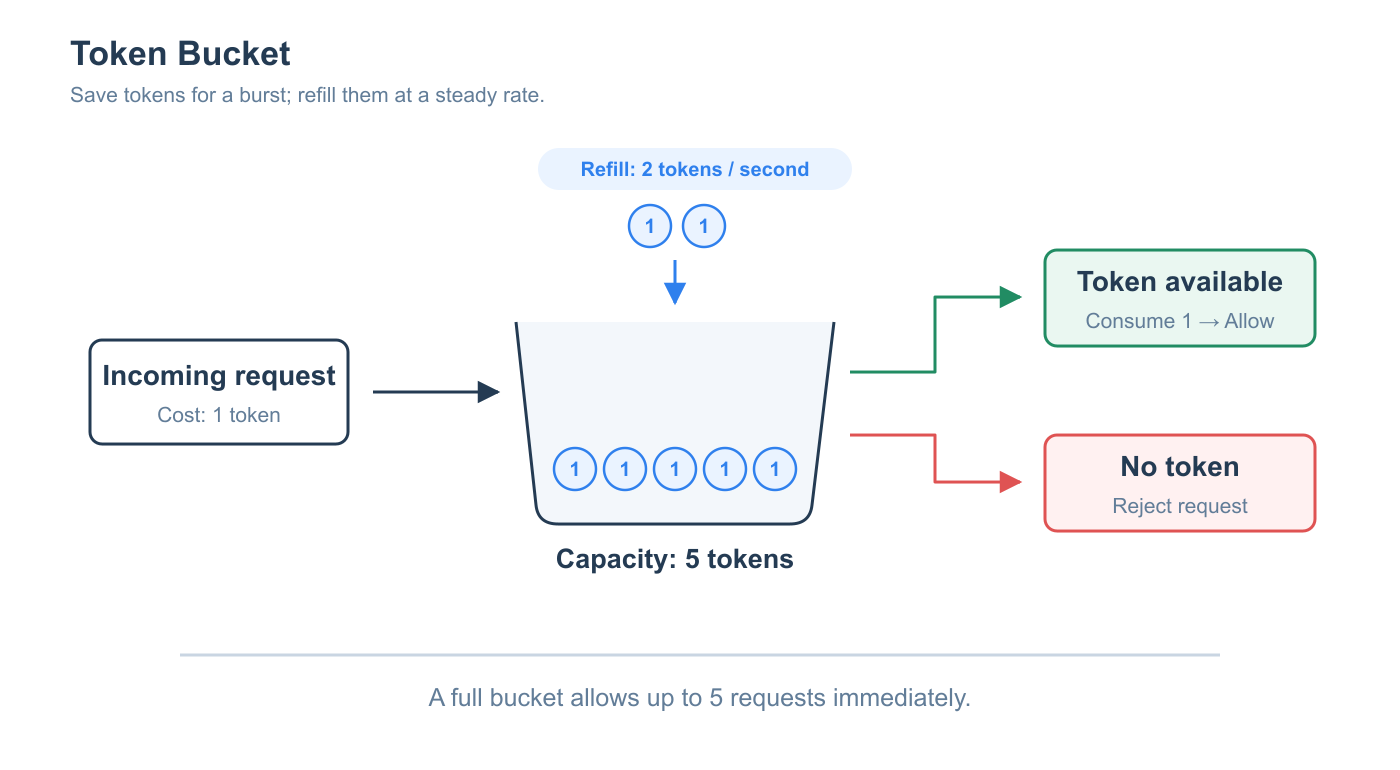
요청이 들어오면 Bucket에서 Token 하나를 꺼낸다. Token이 있으면 요청을 허용하고, Token이 없으면 거부한다.
시간이 지나면 정해진 속도로 Token이 보충된다. 다만 최대 용량이 5개라면 오랫동안 요청이 없어도 5개를 초과해 쌓이지 않는다.
순간적인 요청은 얼마나 허용할까?
Bucket이 가득 차 있다면 요청 5개가 거의 동시에 들어와도 모두 허용할 수 있다. 이렇게 짧은 시간에 요청이 몰리는 것을 Burst라고 한다.
Token을 모두 사용했다면 이후에는 보충되는 Token의 속도에 맞춰 요청을 허용하게 된다.
여기서 Bucket의 용량과 보충 속도는 서로 다른 역할을 한다.
- Bucket Capacity — 쌓아둘 수 있는 Token의 수로, 허용할 Burst 크기에 영향을 준다.
- Refill Rate — 장기적으로 지속할 수 있는 요청 속도를 결정한다.
따라서 초당 Token을 2개 보충한다고 해서 모든 1초 구간에서 요청을 최대 2개만 허용한다는 뜻은 아니다. 이미 저장되어 있던 Token도 사용할 수 있기 때문이다.
실제 구현에서는 반드시 별도의 작업이 주기적으로 Token을 넣을 필요는 없다. 마지막 계산 시각과 현재 시각의 차이를 이용해 요청이 들어올 때 보충량을 계산할 수도 있다.
현재 Token 수
= min(최대 용량, 이전 Token 수 + 경과 시간 × 보충 속도)
이후 Token이 충분한지 확인하고, 허용한 요청의 비용만큼 차감하면 된다.
Leaky Bucket
Token Bucket은 어느 정도의 Burst를 허용했다. 반대로 요청이 한꺼번에 들어오더라도 Server에는 보다 일정한 속도로 전달하고 싶다면 어떻게 해야 할까?
이를 이해하기 위해 바닥에 작은 구멍이 난 Bucket을 생각해볼 수 있다.
물이 한꺼번에 들어오더라도 바닥에서는 일정한 속도로 흘러나간다. Bucket이 가득 찼는데 물이 더 들어오면 넘치게 된다.
여기서는 요청을 Queue에 저장하고 일정한 속도로 꺼내는 Leaky Bucket 방식을 기준으로 살펴보자.
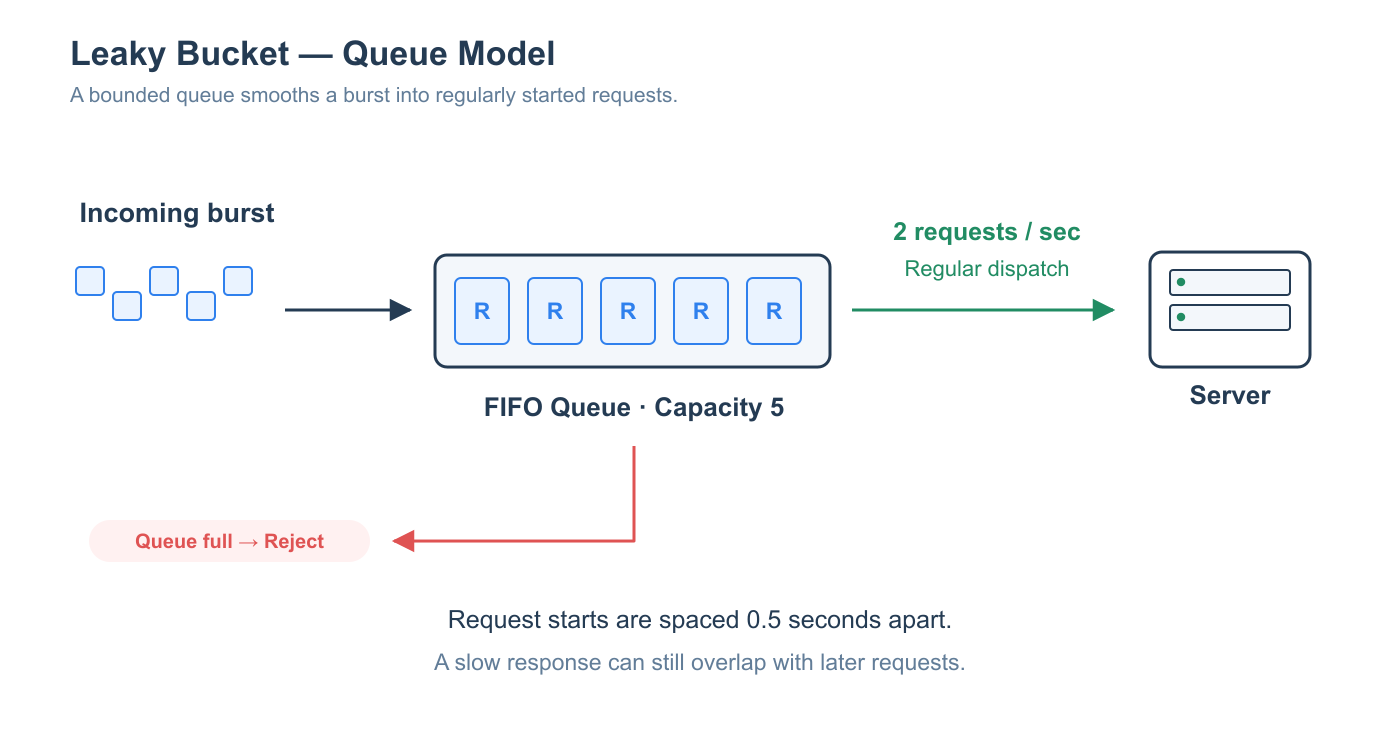
요청이 들어오면 Queue에 넣고, 앞에서부터 정해진 간격으로 Server에 전달한다. 예를 들어 초당 2개라면 0.5초마다 하나씩 전달하는 식이다.
Queue가 가득 찼다면 새로운 요청은 거부한다.
이때 일정하게 만드는 것은 요청을 전달하는 속도이다. 각 요청의 처리 시간이 다를 수 있으므로 응답이 완료되는 시각까지 일정해지는 것은 아니다.
갑자기 몰린 요청을 완충할 수 있지만, Queue에 오래 머무는 요청은 그만큼 지연된다. Queue 크기뿐 아니라 얼마나 기다리게 할지도 함께 고려해야 한다.
또한 Leaky Bucket이라는 이름으로 즉시 허용 여부를 판단하는 구현도 있다. 모든 구현이 실제 요청 Queue를 가진다고 볼 수는 없으며, 여기서는 일정한 속도로 요청을 내보내는 구조를 설명한 것이다.
어떤 알고리즘을 사용해야 할까?
각 알고리즘은 요청을 제한한다는 목적은 같지만, 어떤 상태를 저장하고 어떤 트래픽을 허용하는지가 다르다.
| 알고리즘 | 핵심 방식 | 고려할 점 |
|---|---|---|
| Fixed Window Counter | 고정된 구간의 요청 수 계산 | 구현은 단순하지만 경계에 요청이 몰릴 수 있다. |
| Sliding Window Log | 최근 구간의 Timestamp 저장 | 정확한 제한이 가능하지만 요청 기록을 저장해야 한다. |
| Sliding Window Counter | 이전·현재 구간에 가중치 적용 | 메모리를 줄이는 대신 추정 오차가 있다. |
| Token Bucket | Token 보충과 소비 | Burst 크기와 지속 요청 속도를 따로 조절한다. |
| Leaky Bucket (Queue) | Queue에서 일정한 속도로 전달 | 전달 속도를 고르게 만들지만 대기 시간이 생긴다. |
단순한 제한이면 Fixed Window로 시작할 수 있고, 최근 구간의 제한을 정확히 지켜야 한다면 Sliding Window Log를 고려할 수 있다.
어느 정도의 Burst를 허용할지 조절하려면 Token Bucket이, 일정한 전달 속도가 필요하고 대기 시간을 감수할 수 있다면 Queue 방식의 Leaky Bucket이 잘 맞을 수 있다.
결국 어떤 알고리즘이 항상 더 좋다기보다는 어떤 요청 패턴을 허용하고, 어느 정도의 오차와 지연을 감수할 것인지가 중요하다.
서버가 여러 대라면?
지금까지는 요청을 제한하는 방법 자체를 살펴보았다. 그런데 이전 글처럼 Web Server를 Scale Out한 환경에서는 또 다른 문제가 생긴다.
Server A, B, C가 각각 자신의 메모리에 요청 수를 저장하고, 사용자 한 명당 1분에 100번을 허용한다고 가정해보자.
Server A → User 1의 요청 100개 허용
Server B → User 1의 요청 100개 허용
Server C → User 1의 요청 100개 허용
동일한 사용자의 요청이 세 서버로 분산되면 전체적으로 최대 300개까지 허용될 수 있다. 각 서버가 다른 서버에서 처리한 요청 수를 모르기 때문이다.
따라서 서비스 전체에서 하나의 제한을 적용하려면 여러 서버가 같은 제한 상태를 기준으로 판단해야 한다.
이를 위해 Redis 같은 공용 저장소에 Counter, Timestamp, Token 수 등을 저장하는 구조를 사용할 수 있다.
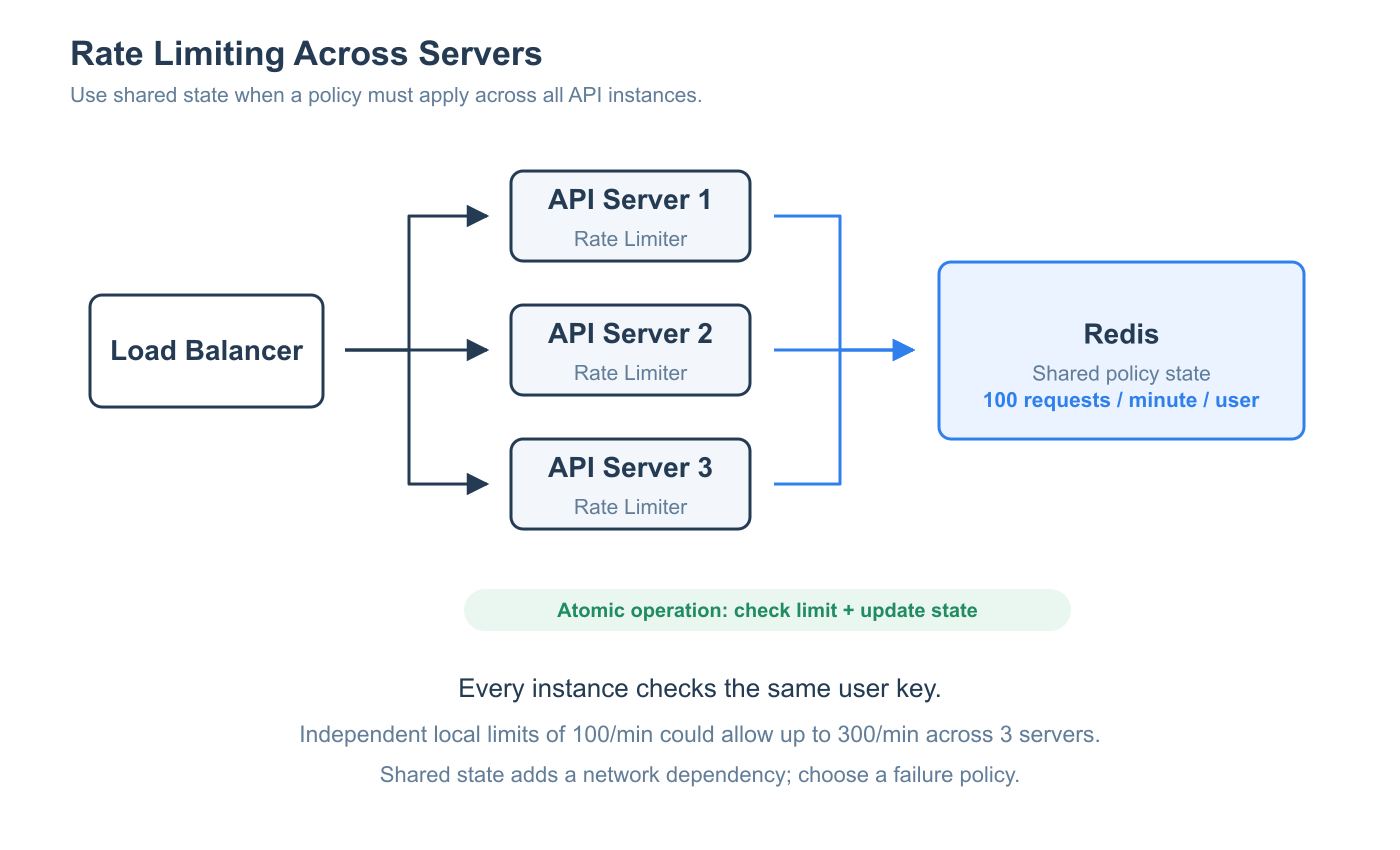
이제 요청이 어느 Server로 들어오더라도 같은 사용자의 상태를 확인한다. 제한에 사용되는 Key에는 사용자 ID뿐 아니라 적용할 정책이나 API 정보도 포함할 수 있다.
Redis에 저장하면 끝일까?
하지만 저장소만 공유한다고 해서 문제가 모두 해결되지는 않는다.
현재 Counter가 99이고 최대 허용량이 100일 때, 두 서버가 동시에 요청을 검사한다고 가정해보자.
Server A → Counter 99 조회 → 허용 가능
Server B → Counter 99 조회 → 허용 가능
Server A → Counter 증가 → 요청 허용
Server B → Counter 증가 → 요청 허용
남은 자리는 하나였지만 두 요청 모두 허용되었다. 이처럼 여러 작업이 동시에 같은 상태를 읽고 변경하면서 결과가 달라지는 문제를 Race Condition이라고 한다.
이를 막으려면 상태 조회 → 허용 여부 판단 → 상태 갱신을 하나의 원자적인 작업으로 처리해야 한다.
Redis의 INCR 자체는 원자적이다. 다만 위 예시처럼 조회와 판단을 별도로 수행하거나, Counter를 만든 뒤 EXPIRE를 따로 호출하는 전체 흐름까지 자동으로 원자적이 되는 것은 아니다.
여러 단계가 필요한 경우에는 Lua Script 등을 이용해 하나로 묶을 수 있다. 예를 들어 Counter 확인, 허용된 요청 반영, 필요한 만료 설정을 다른 요청이 중간에 끼어들지 못하도록 처리하는 것이다.
다만 Script 실행 중에는 다른 Redis 작업이 기다릴 수 있으므로 처리 내용은 짧게 유지해야 한다.
만료 시간인 TTL도 알고리즘에 맞게 설정해야 한다. Sliding Window Counter에서는 이전 Window의 Counter가 다음 Window의 계산에도 필요하므로, Window가 끝났다고 즉시 삭제하면 안 된다.
공유 저장소에 장애가 발생한다면?
공유 저장소를 사용하면 네트워크 통신 비용이 추가되고, 저장소에 접근할 수 없는 상황도 고려해야 한다.
이때 요청을 어떻게 처리할 것인지도 미리 정해야 한다.
- Fail Open — 제한 여부를 확인할 수 없어도 요청을 통과시킨다. 가용성을 우선하지만 보호 기능이 약해질 수 있다.
- Fail Closed — 제한 여부를 확인할 수 없으면 요청을 거부한다. 보호를 우선하지만 정상 사용자도 영향을 받을 수 있다.
어느 쪽이 적절한지는 API의 비용과 서비스 요구사항에 따라 달라진다. 제한 초과와 저장소 장애는 원인이 다르므로, 장애까지 무조건 429로 응답하기보다는 응답 정책도 구분하는 것이 좋다.
규모가 더 커지면 공유 저장소 자체의 처리량, 데이터 복제의 지연, 서버 간 시간 차이도 영향을 준다. 공용 Redis를 둔다는 설계만으로 모든 장애 상황에서 정확한 전역 제한까지 보장되는 것은 아니다.
정리
처음에는 단순히 1분에 100번까지만 허용하면 되는 문제처럼 보였다.
하지만 어느 1분을 기준으로 볼 것인지, 순간적으로 몰리는 요청은 얼마나 허용할 것인지에 따라 선택할 수 있는 알고리즘이 달라졌다.
Fixed Window는 고정된 시간 구간의 요청을 세고, Sliding Window는 현재 시점에서 최근 요청을 확인한다. Token Bucket은 Token의 용량과 보충 속도로 요청을 조절하고, Queue 방식의 Leaky Bucket은 요청을 일정한 속도로 전달한다.
여러 서버가 있는 환경에서는 제한 상태를 공유하는 것뿐 아니라 원자적인 갱신과 저장소 장애 시의 동작도 함께 고려해야 한다.
결국 Rate Limiter의 핵심은 서비스가 감당할 수 있는 범위 안에서 요청을 받아들이고, 일부의 과도한 요청이 전체 사용자에게 영향을 주는 것을 줄이는 것이라고 볼 수 있다.
다만 사용자별 제한을 지켜도 사용자가 많아지면 전체 부하는 커질 수 있고, 오래 실행되는 요청이 쌓이는 문제도 남는다. 필요하다면 서비스 전체의 요청량이나 동시에 처리하는 요청 수도 별도로 제한해야 한다.
지금까지는 더 많은 요청을 처리하기 위해 시스템을 확장하는 방법을 살펴봤는데, 안정적인 시스템을 만들기 위해서는 언제 요청을 받아들이지 않을지도 함께 설계해야 한다는 것을 알 수 있었다.
그리고 제한된 요청을 Client가 즉시 반복해서 다시 보낸다면 또 다른 문제가 생길 수 있다. 다음에는 Retry, Exponential Backoff, Jitter를 통해 실패한 요청을 어떻게 다시 시도할 수 있는지 살펴보면 좋을 것 같다.
참고
'CS' 카테고리의 다른 글
| Retry, Backoff, Jitter (0) | 2026.10.04 |
|---|---|
| Consistent Hashing (0) | 2026.09.30 |
| [네트워크] ICMP 프로토콜 (1) | 2026.01.10 |
| [네트워크] ARP 프로토콜 (0) | 2026.01.08 |
| [네트워크] 라우팅, 클래스풀 IP, 클래스리스 IP (0) | 2025.12.20 |