최근에는 AI를 이용해 코드를 작성하거나 문서를 정리하는 일이 꽤 익숙해졌다.
이전에도 이야기했듯이 개발 과정에서 Agent의 도움을 받는 경우가 많아지면서, AI가 어떻게 동작하는지도 조금씩 공부해보려고 한다.
대학에서도 인공지능에 대해 배웠지만 시간이 지나며 그 기억이 많이 희석됐고,
가장 최근 트렌드가 궁금해서 간단하게 조사해보았다.
AI에 대해 찾아보다 보면 머신러닝, 딥러닝, 생성형 AI, LLM과 같은 용어들이 함께 등장한다.
예전에는 머신러닝이라는 말을 많이 들었던 것 같은데, 최근에는 대부분 LLM을 이야기하는 것처럼 느껴졌다.
그렇다면 AI가 머신러닝에서 시작해서 딥러닝을 거쳐 LLM으로 바뀐 것일까?
먼저 이 용어들이 각각 무엇을 의미하는지부터 알아보자.
AI
AI는 Artificial Intelligence의 약자로, 인공지능을 의미한다.
사람의 지능이 필요한 학습, 추론, 탐색과 같은 일을 컴퓨터로 수행하도록 만드는 넓은 분야이다.
흔히 AI라고 하면 데이터를 학습한 모델을 떠올리지만, AI가 반드시 이런 방식으로만 동작하는 것은 아니다.
사람이 지식을 규칙으로 정리하고 그 규칙에 따라 답을 찾거나, 가능한 선택지를 탐색하면서 문제를 해결하는 방법도 AI 연구에서 다뤄왔다.
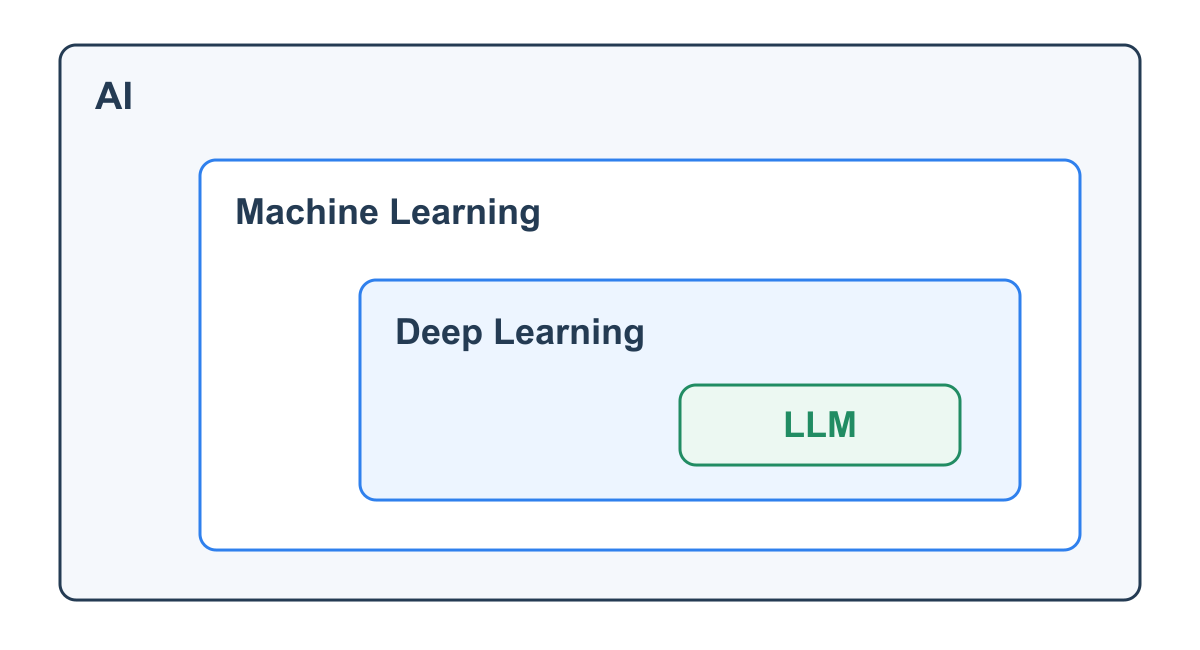
위와 같이 AI 안에 머신러닝이 있고, 머신러닝 안에 딥러닝이 포함된다.
현재 널리 사용하는 LLM(Large Language Model) 역시 딥러닝을 기반으로 만들어진 언어 모델이다.
이 그림은 기술이 바뀐 순서를 보여주는 것이 아니라, 각 개념이 포함되는 관계를 보여준다.
머신러닝
머신러닝(Machine Learning)은 데이터에서 패턴을 학습하고, 이를 이용해 새로운 입력에 대한 결과를 예측하는 방법이다.
말로만 보면 조금 추상적이기 때문에 메일 서비스에서 스팸 메일을 분류하는 상황을 생각해보자.
가장 단순하게는 개발자가 특정 광고 문구가 들어 있거나 의심스러운 주소에서 보낸 메일을 스팸으로 분류하도록 규칙을 만들 수 있다.
하지만 광고 문구가 계속 달라진다면 어떻게 될까?
새로운 문구가 나올 때마다 규칙을 추가해야 하고, 정상적인 메일이 스팸으로 분류되는 경우에는 예외도 처리해야 한다.
머신러닝에서는 스팸 여부가 표시된 기존 메일을 모아 모델을 학습시킬 수 있다.
모델이 메일의 내용과 스팸 여부 사이의 관계를 학습하고, 새로운 메일이 들어오면 스팸일 가능성을 예측하는 것이다.
이처럼 정답이 표시된 데이터로 학습하는 방식을 지도학습(Supervised Learning)이라고 한다.
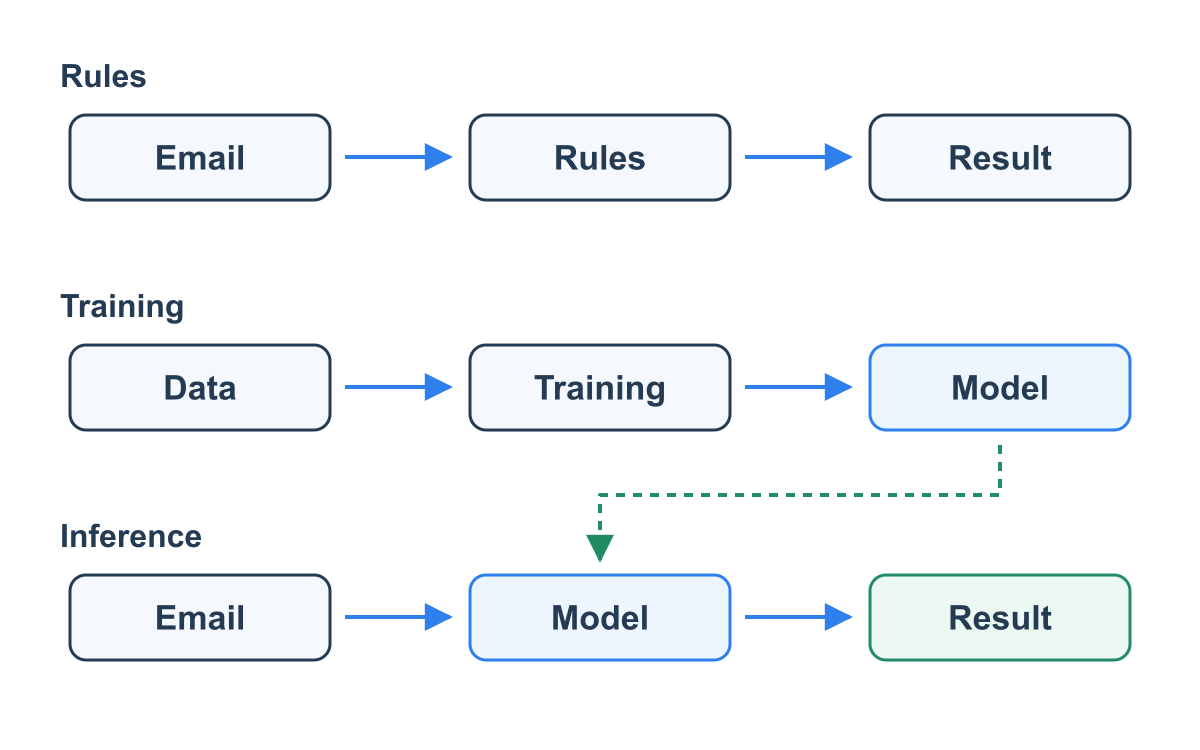
위 그림의 첫 번째 흐름에서는 개발자가 직접 정한 규칙으로 메일을 분류한다.
반면 두 번째 흐름에서는 기존 메일과 정답 데이터로 모델을 학습하고, 세 번째 흐름에서는 학습된 모델로 새로운 메일을 분류한다.
차이는 분류 기준을 사람이 직접 정하는지, 데이터를 통해 모델이 학습하는지에 있다.
실제 서비스에서는 규칙과 머신러닝 모델을 함께 사용할 수도 있다.
학습과 추론
여기서 모델을 학습시키는 과정과 실제로 사용하는 과정은 구분할 필요가 있다.
기존 메일과 스팸 여부를 이용해 모델의 값을 조정하는 과정이 학습(Training)이다.
이후 학습된 모델에 새로운 메일을 넣고 스팸 여부를 예측하는 과정이 추론(Inference)이다.
따라서 여기서 말하는 추론은 학습된 모델로 결과를 계산하는 과정이라고 이해하면 된다.
또한 학습에 사용한 메일을 잘 분류한다고 해서 새로운 메일까지 잘 분류하는 것은 아니다. 처음 보는 데이터에서도 제대로 동작하는지 확인해야 한다.
지도학습을 예로 들었지만, 모든 머신러닝이 정답 데이터를 사용하는 것은 아니다.
정답 없이 데이터의 구조를 찾는 비지도학습이나, 행동에 대한 보상을 이용하는 강화학습도 있다. 각각의 학습 방법은 이후 글에서 따로 알아보려고 한다.
딥러닝
앞에서 머신러닝은 데이터를 통해 모델을 학습하는 방법이라고 했다.
이때 사용하는 모델의 종류도 여러 가지인데, 여러 층으로 구성된 신경망을 사용하는 방법이 딥러닝(Deep Learning)이다.
신경망은 입력값을 받아 가중치와 같은 값으로 계산하고, 그 결과를 다음 층으로 전달하면서 최종 결과를 만드는 모델이다.
학습 과정에서는 예측 결과와 정답의 차이를 줄이도록 이 값들을 조정한다.
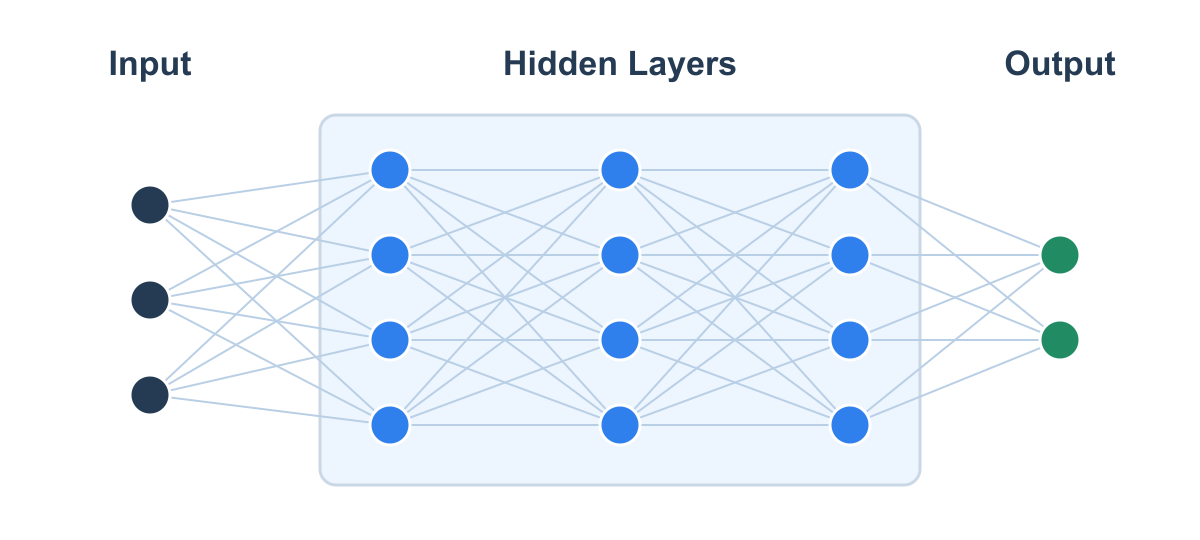
위 그림은 신경망의 구조를 단순하게 표현한 것이다.
입력과 출력 사이에 여러 은닉층(Hidden Layer)이 있고, 앞선 층의 계산 결과가 다음 층으로 전달된다.
스팸 메일 분류에 사용한다면 메일의 내용을 숫자로 표현해 입력하고, 여러 층의 계산을 거쳐 스팸 여부를 예측할 수 있다.
예를 들어 사람이 직접 분류 기준을 정한다면, 어떤 단어나 표현이 스팸을 판단하는 데 도움이 되는지 하나씩 찾아야 한다.
신경망에서는 많은 메일과 스팸 여부를 함께 보여주고, 예측이 틀릴 때마다 계산에 사용하는 값들을 조정한다. 이 과정을 반복하면서 어떤 단어와 표현의 조합이 스팸 메일에서 자주 나타나는지 학습할 수 있다.
즉, 사람이 모든 분류 기준을 직접 정하는 대신, 데이터를 통해 스팸을 구분하는 데 도움이 되는 기준을 학습하는 것이다.
그렇다고 모든 문제에 딥러닝을 사용해야 하는 것은 아니다.
데이터의 양과 문제의 성격, 필요한 계산 비용에 따라 다른 머신러닝 모델이 더 적절할 수 있다. 층을 많이 쌓는다고 항상 성능이 좋아지는 것도 아니다.
LLM
LLM은 Large Language Model의 약자로, 대규모 언어 모델을 의미한다.
많은 텍스트를 통해 언어의 패턴을 학습한 규모가 큰 모델이며, 현재의 대표적인 LLM은 Transformer라는 신경망 구조를 기반으로 한다.
여기서 모델의 규모는 가중치처럼 학습 과정에서 조정하는 값인 Parameter의 수와 관련된다.
앞에서는 메일을 스팸과 정상 메일로 분류하는 모델을 살펴봤다.
반면 대화형 LLM은 주어진 문맥에 이어지는 텍스트를 생성한다. 이를 이용해 질문에 답하거나, 문서를 요약하고 코드를 작성할 수 있다.
그렇다면 긴 답변은 어떻게 만들어지는 것일까?
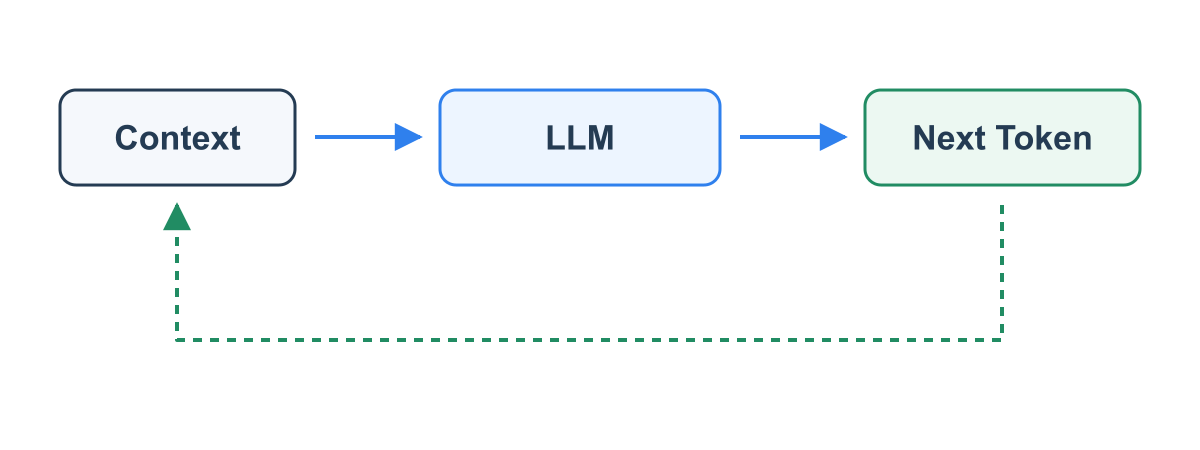
대화형 LLM에서 널리 사용하는 방식은 현재 문맥을 바탕으로 다음 Token을 하나씩 생성하는 것이다.
입력 문장은 Token이라는 단위로 나뉘어 처리된다. Token은 항상 단어 하나와 같지는 않으며, 단어의 일부나 문자 등이 될 수도 있다.
모델은 현재 문맥에서 다음에 올 Token의 확률을 계산하고, 그중 하나를 선택한다.
선택한 Token을 기존 문맥에 추가한 뒤 다시 다음 Token을 생성한다. 위 그림의 점선은 이렇게 문맥을 늘려가며 반복하는 과정을 나타낸다.
이 과정을 반복하면서 하나의 긴 답변이 만들어지는 것이다.
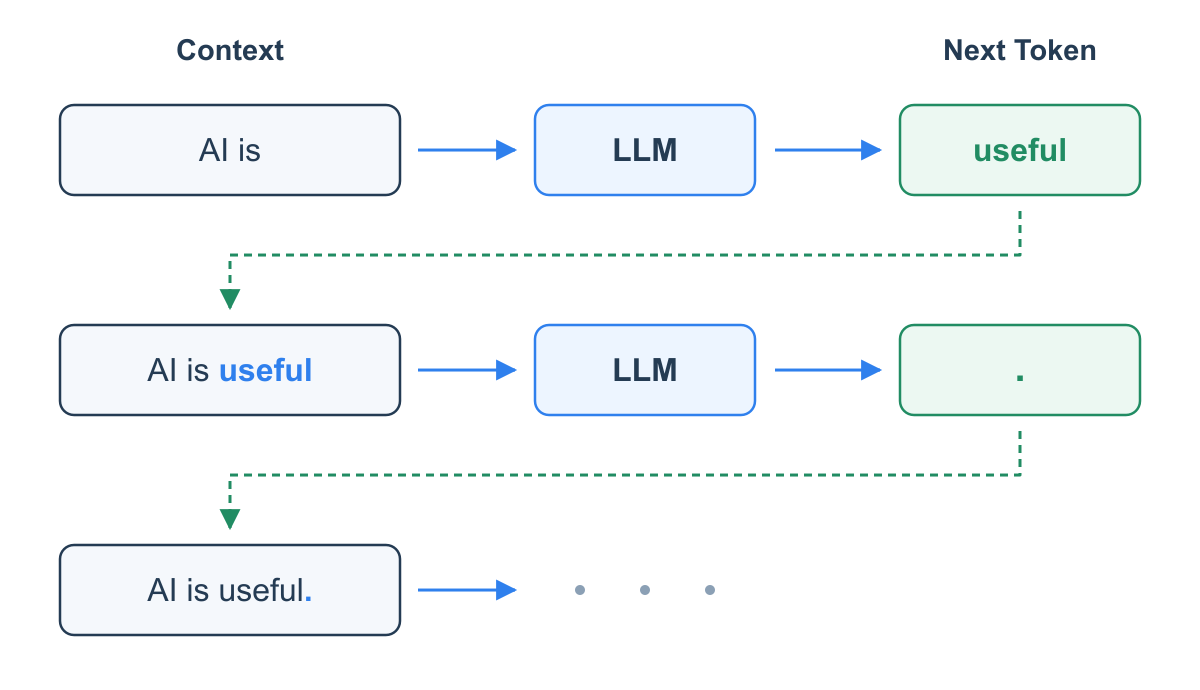
예를 들어 현재 문맥이 “AI is”라고 가정해보자.
모델이 다음 Token으로 “ useful”을 생성하면, 문맥은 “AI is useful”이 된다. 이후에는 처음의 “AI is”가 아니라, 새로 생성한 Token까지 포함된 문맥을 바탕으로 다음 Token을 예측한다.
다음 Token으로 “.”이 생성되면 문맥은 “AI is useful.”로 늘어난다. 이렇게 지금까지 생성한 내용까지 다음 계산에 포함하면서 답변을 이어가는 것이다.
위 그림의 Token 구분은 이해를 위한 예시이며, 실제 구분은 사용하는 Tokenizer에 따라 달라질 수 있다.
다만 자연스러운 문장을 만든다고 해서 내용까지 항상 정확한 것은 아니다.
실제로 존재하지 않는 정보나 잘못된 설명을 그럴듯하게 만들 수도 있기 때문에 결과를 확인할 필요가 있다.
또한 문장 생성 자체가 최신 자료를 검색하는 과정은 아니다. 검색이나 외부 도구를 연결하는 기능은 LLM을 사용하는 서비스에서 별도로 구성할 수 있다.
생성형 AI와의 관계
LLM과 함께 생성형 AI라는 표현도 자주 등장한다.
생성형 AI는 텍스트, 이미지, 음성처럼 새로운 콘텐츠를 생성하는 AI를 의미한다.
텍스트를 생성하는 LLM이 대표적인 예시지만, 이미지를 생성하는 모델도 있기 때문에 생성형 AI 전체를 LLM이라고 부르는 것은 아니다.
딥러닝은 어떤 방법으로 모델을 만드는지에 대한 표현이고, 생성형 AI는 무엇을 하는지에 대한 표현이다.
따라서 딥러닝으로 만든 모델이 생성형 AI이면서 LLM일 수도 있다.
AI의 발전 흐름
AI 연구에서는 규칙과 탐색, 데이터를 이용한 학습, 신경망 등 여러 방법이 함께 연구되어 왔다.
이후 사용할 수 있는 데이터가 많아지고 GPU와 학습 방법이 발전하면서, 규모가 큰 신경망을 학습시키는 일이 확대되었다.
대표적으로 2012년 발표된 AlexNet은 이미지 분류에서 깊은 신경망과 GPU를 활용해 좋은 성능을 보였다. 딥러닝이 이미지 인식에서 주목받게 된 계기 중 하나이다.
2017년에는 Attention Is All You Need 논문에서 Transformer가 제안되었고, 이후 대규모 언어 모델을 만드는 중요한 기반이 되었다.
하지만 LLM이 등장했다고 해서 이전의 머신러닝 방법들이 사라진 것은 아니다.
추천, 수요 예측, 이미지 인식 등 해결하려는 문제에 따라 지금도 다양한 모델이 사용된다.
LLM 역시 머신러닝과 딥러닝의 발전 위에서 만들어진 언어 모델이라고 이해하면 된다.
마무리
이번 글에서는 AI와 함께 자주 등장하는 용어들의 관계를 간단하게 알아보았다.
| 개념 | 의미 |
| AI | 지능적인 문제 해결을 컴퓨터로 구현하는 넓은 분야 |
| 머신러닝 | 데이터에서 패턴을 학습해 결과를 예측하는 방법 |
| 딥러닝 | 여러 층의 신경망을 사용하는 머신러닝 방법 |
| LLM | 대규모 언어 모델. 현대의 대표적인 모델은 딥러닝을 기반으로 한다. |
포함 관계를 먼저 정리하고 나니, LLM도 결국 데이터를 학습하는 모델이라는 점에서 머신러닝과 연결된다는 것을 이해할 수 있었다.
다음 글에서는 머신러닝의 학습과 추론에 대해 조금 더 자세히 알아보려고 한다.
모델을 학습시킨다는 것이 무엇을 바꾸는 과정인지, 학습된 모델을 실제로 사용할 때는 어떤 일이 일어나는지 이어서 살펴봐야겠다.
참고
- IBM — AI vs. Machine Learning vs. Deep Learning vs. Neural Networks
- Google — What is Machine Learning?
- Google — Machine Learning Glossary
- Google — Neural networks
- Google — LLMs: What's a large language model?
- Krizhevsky et al. — ImageNet Classification with Deep Convolutional Neural Networks (2012)
- Vaswani et al. — Attention Is All You Need (2017)
- IBM — The history of artificial intelligence
'AI' 카테고리의 다른 글
| 머신러닝의 학습과 추론 (0) | 2026.10.07 |
|---|